Deep RL 개념 노트
시험 범위 슬라이드 5–62쪽(MDP → Bellman expectation/optimality → DP → MC → TD → TD(λ))을 빠짐없이 순서대로 풀어 썼습니다. 쪽 번호는 슬라이드 오른쪽 아래의 “○○ / 163” 기준입니다. 계산 예제는 직접 돌려 볼 수 있고, 원본 슬라이드(필기 포함)는 누르면 크게 보입니다.
형광펜 · 메모 — 본문을 드래그(모바일은 길게 눌러 선택)하면 색 막대가 뜹니다. 칠한 부분을 누르면 색 변경·메모·삭제, 오른쪽 아래 버튼에서 모아 보기.
한 장으로 보는 큰 그림
이 노트 전체(5–62쪽)는 결국 한 문장입니다. Bellman 방정식을 푸는 방법이 상황에 따라 어떻게 달라지는가.
앞부분(17–25쪽)에서 우리는 “좋은 정책을 찾으려면 value function을 알아야 하고, value function은 Bellman equation을 만족한다”는 것을 배웠습니다. 문제는 이 방정식을 실제로 어떻게 푸느냐입니다. 답은 우리가 환경에 대해 얼마나 아는지에 달려 있습니다.
환경의 규칙을 안다 (known MDP)
\(p(s',r|s,a)\)를 알고 있습니다. 직접 움직이지 않고 머릿속 계산만으로 답을 낼 수 있으므로 planning이라 하고, 그 도구가 Dynamic Programming입니다. → Value Iteration, Policy Iteration
환경의 규칙을 모른다 (unknown MDP)
\(p\)를 모르므로 직접 해 보고 결과(샘플)에서 배워야 합니다. 그래서 learning이라 하고, 그 도구가 Reinforcement Learning입니다. → Monte Carlo, Sarsa, Q-learning
서울 지하철 노선도와 각 구간 소요시간을 모두 아는 사람은 집에서 최단 경로를 계산할 수 있습니다. 이것이 DP입니다. 처음 간 도시에서 지도 없이 길을 찾는 사람은 여러 번 걸어 보며 “이 골목으로 가면 대체로 빨랐다”는 경험을 쌓아야 합니다. 이것이 RL입니다. MC는 목적지에 도착한 뒤 걸린 시간 전체를 보고 배우고, TD는 한 정거장 갈 때마다 “남은 시간 예상치”를 고쳐 가며 배웁니다.
앞으로 나올 모든 알고리즘은 아래 두 가지 Bellman 식 중 하나를 “계산(DP)” 또는 “샘플로 근사(RL)”하는 방법입니다. 이 두 식을 기준점으로 삼고 읽어 나가세요.
두 식의 차이는 \(\sum_a\pi(a|s)\)가 \(\max_a\)로 바뀐 것 하나뿐입니다. expectation 식은 “정해진 정책을 따랐을 때의 가치”, optimality 식은 “매번 최선을 골랐을 때의 가치”입니다.
기초 다지기: 확률변수로 Bellman 식 다시 읽기 Q&A
공부하면서 실제로 막혔던 질문 네 개입니다. 본문에 들어가기 전에 확률변수·값·사건 기호부터 정리해 두면 뒤의 Bellman 식이 “읽힙니다”. 처음엔 Q2·Q3만 읽고, Q1·Q4는 20쪽 유도를 본 뒤 다시 와도 됩니다.
Q1Bellman expectation 방정식은 v, q 두 개가 있는 건가?
네. 같은 원리(“지금 한 걸음 + 할인된 다음 가치”)를 상태 기준(\(v_\pi\))과 상태-행동 기준(\(q_\pi\))으로 각각 쓴 것입니다. 21쪽 그림 네 개가 정확히 이 구조입니다.
| 한 층 (서로를 잇는 식) | 두 층 (자기 자신으로 돌아오는 식) | |
|---|---|---|
| \(v_\pi\) | \(v_\pi(s)=\sum_a\pi(a|s)q_\pi(s,a)\) | \(v_\pi(s)=\sum_a\pi(a|s)[R^a_s+\gamma\sum_{s'}P^a_{ss'}v_\pi(s')]\) |
| \(q_\pi\) | \(q_\pi(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}v_\pi(s')\) | \(q_\pi(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}\sum_{a'}\pi(a'|s')q_\pi(s',a')\) |
한 층짜리 두 식을 서로 대입하면 두 층짜리 식이 나옵니다. 그래서 “방정식이 두 개”라기보다 “두 함수가 서로를 통해 정의되고, 대입하면 각자 재귀식이 된다”고 보는 게 정확합니다. optimality도 똑같이 \(v_*\), \(q_*\) 두 개가 있습니다(25쪽).
Q2누적보상 \(G_t\)도 확률변수인가?
네. \(G_t=R_{t+1}+\gamma R_{t+2}+\gamma^2R_{t+3}+\cdots\)에서 앞으로 받을 보상 \(R_{t+1},R_{t+2},\dots\)가 전부 아직 정해지지 않은 확률변수이고, 확률변수들의 합인 \(G_t\)도 확률변수입니다. 이 점이 Bellman expectation equation을 이해하는 열쇠입니다.
상태 \(s\)에서 \(a\)를 하면 반드시 보상 2를 받고 B로 갑니다. B에서는 정책이 25% 확률로 왼쪽(+10, 종료), 75% 확률로 오른쪽(+4, 종료)을 고릅니다. \(\gamma=0.9\).
\[G_t=R_{t+1}+0.9R_{t+2}=\begin{cases}2+0.9(10)=11 & \text{확률 }0.25\\ 2+0.9(4)=5.6 & \text{확률 }0.75\end{cases}\] \[q_\pi(s,a)=\mathbb E_\pi[G_t|S_t=s,A_t=a]=0.25(11)+0.75(5.6)=6.95\]같은 \(s\)에서 같은 \(a\)를 해도 \(G_t\)는 11일 수도, 5.6일 수도 있습니다(실제로 한 번 해 보고 얻은 값은 실현값 \(g_t\)). 그 평균이 하나의 숫자 \(q_\pi(s,a)=6.95\)입니다.
| 표현 | 정체 | 위 예에서 |
|---|---|---|
| \(G_t\) | 확률변수 (미래의 누적보상) | 11 또는 5.6 |
| \(g_t\) | 한 번 실행해서 관측한 값 | 예: 11 |
| \(q_\pi(s,a)\) | \(s,a\)를 고정했을 때 \(G_t\)의 조건부 기댓값 → 숫자 | 6.95 |
| \(q_\pi(S_{t+1},A_{t+1})\) | 함수는 같지만 입력이 확률변수 → 다시 확률변수 | 다음 상태·행동에 따라 달라짐 |
그리고 \(G_t=R_{t+1}+\gamma G_{t+1}\)은 기댓값을 취하기 전, 확률변수끼리 성립하는 등식입니다. 여기서 주의할 점은 \(G_{t+1}\neq q_\pi(S_{t+1},A_{t+1})\)라는 것입니다(매번 같은 값이 아님). \(G_{t+1}\)은 실제로 일어날 누적보상이고 \(q_\pi(S_{t+1},A_{t+1})\)는 그 예상치입니다. 다만 조건부 기댓값을 취하면 같아지기 때문에 Bellman 식에서 서로 바꿔 쓸 수 있습니다: \(\mathbb E_\pi[G_{t+1}|S_{t+1},A_{t+1}]=q_\pi(S_{t+1},A_{t+1})\).
생각해 볼 질문: \(G_t\)가 확률변수라면 \(v_\pi(S_t)\)는? → 함수 \(v_\pi\)에 확률변수 \(S_t\)를 넣었으니 이것도 확률변수입니다. \(v_\pi(s)\)처럼 소문자 값을 넣어야 숫자가 됩니다.
Q3\(X\), \(x\), \(X=x\)는 어떻게 구분하나? \(f(x)\)를 \(f(X=x)\)라고 쓰면 안 되나?
셋은 수학적으로 종류가 완전히 다른 대상입니다. 하나의 기댓값 식 안에 함께 나와서 헷갈릴 뿐입니다.
| 표현 | 정체 | 주사위 예 |
|---|---|---|
| \(X\) | 확률변수: 결과 \(\omega\)에 숫자를 붙이는 함수 \(X:\Omega\to\mathbb R\) | 주사위 눈 |
| \(x\) | \(X\)가 가질 수 있는 값 하나 | 3 |
| \(X=x\) | 사건: \(\{\omega\in\Omega : X(\omega)=x\}\), 표본공간의 부분집합 | “눈이 3이 나옴” |
| \(P(X=x)\) | 그 사건의 확률 | 1/6 |
| \(f(X)\) | 확률변수를 넣은 결과 = \(f\circ X\) → 또 하나의 확률변수 | \(X^2\): 1, 4, …, 36 중 하나 |
| \(f(x)\) | 값을 넣은 결과 → 숫자 | \(f(3)=9\) |
그래서 \(\mathbb E[f(X)]=\sum_xP(X=x)f(x)\)는 “\(X\)가 가질 수 있는 값 \(x\)를 하나씩 순회하면서(\(x\)는 합산용 더미 변수), 그 값일 때의 출력 \(f(x)\)에 그 값이 나올 확률을 곱해 더한다”는 뜻입니다. 공정한 주사위에서 \(f(x)=x^2\)이면 \(\mathbb E[X^2]=\frac16(1+4+9+16+25+36)=\frac{91}{6}\)입니다.
\(f(X=x)\)는 쓰면 안 됩니다. \(f\)는 숫자를 받는 함수(\(f:\mathbb R\to\mathbb R\))인데 \(X=x\)는 숫자가 아니라 사건(집합)이라서 타입이 맞지 않습니다. “\(X=3\)일 때의 값”을 쓰고 싶다면 \(\left.f(X)\right|_{X=3}=f(3)=9\)처럼 쓰고, 조건부 기댓값이면 \(\mathbb E[f(X)|X=3]=f(3)=9\)라고 씁니다. 사건은 함수 괄호 안이 아니라 조건(\(|\) 뒤)이나 확률 \(P(\cdot)\) 안에 들어갑니다.
대문자 \(S_{t+1},A_{t+1},R_{t+1},G_t\) = 확률변수, 소문자 \(s',a',r\) = 그 값, \(S_{t+1}=s'\) = 사건(조건). 그래서
\[\underbrace{\sum_{s',r,a'}p(s',r|s,a)\pi(a'|s')\big[r+\gamma q_\pi(s',a')\big]}_{\text{값을 하나씩 넣어 가중합}}=\underbrace{\mathbb E_\pi\big[R_{t+1}+\gamma q_\pi(S_{t+1},A_{t+1})\,\big|\,S_t=s,A_t=a\big]}_{\text{확률변수째 넣고 기댓값}}\]두 쪽은 같은 계산을 다른 표기로 쓴 것입니다. 왼쪽은 \(\sum_xP(X=x)f(x)\) 꼴, 오른쪽은 \(\mathbb E[f(X)]\) 꼴입니다.
Q4\(q_\pi\) 식의 첫 줄(Σ 꼴)에서 둘째 줄(\(\mathbb E\) 꼴)로 갈 때, 왜 \(\gamma\) 바로 뒤에 \(q_\pi(S_{t+1},A_{t+1})\)가 붙나?
두 단계로 나눠 보면 보입니다.
- \(r\)을 \(\sum_{a'}\) 안으로 넣기. \(\sum_{a'}\pi(a'|s')=1\)이므로 \(r=\sum_{a'}\pi(a'|s')\,r\)입니다. 그러면 \[r+\gamma\sum_{a'}\pi(a'|s')q_\pi(s',a')=\sum_{a'}\pi(a'|s')\big[r+\gamma q_\pi(s',a')\big]\] 이고, 전체는 \(q_\pi(s,a)=\sum_{s',r,a'}p(s',r|s,a)\,\pi(a'|s')\,[r+\gamma q_\pi(s',a')]\)가 됩니다.
- 곱해진 확률을 하나의 결합확률로 보기. \(p(s',r|s,a)\cdot\pi(a'|s')\)는 “다음 상태가 \(s'\), 보상이 \(r\)이고, 이어서 정책이 \(a'\)을 고를” 결합확률입니다. 가능한 모든 \((s',r,a')\)에 대해 확률 × 값을 더했으니, 기댓값의 정의(\(\sum_xP(X=x)f(x)=\mathbb E[f(X)]\)) 그대로 \(\mathbb E_\pi[R_{t+1}+\gamma q_\pi(S_{t+1},A_{t+1})|S_t=s,A_t=a]\)입니다.
여기서 \(\sum_{a'}\pi(a'|s')q_\pi(s',a')\)와 \(q_\pi(S_{t+1},A_{t+1})\)는 그 자체로 같은 것이 아닙니다. 정확한 관계는 \(\sum_{a'}\pi(a'|s')q_\pi(s',a')=\mathbb E_\pi[q_\pi(S_{t+1},A_{t+1})|S_{t+1}=s']\)입니다. 둘째 줄에서는 바깥의 \(\mathbb E_\pi\)가 이 평균까지 한꺼번에 해 주기 때문에, 안에 \(\sum_{a'}\pi\)를 다시 쓰지 않는 것입니다.
왜 하필 \(q_\pi\)인가(근본 이유): \(G_t=R_{t+1}+\gamma G_{t+1}\)이고, 다음 상태와 행동이 주어졌을 때 미래 누적보상의 조건부 기댓값은 정의상 \(\mathbb E_\pi[G_{t+1}|S_{t+1},A_{t+1}]=q_\pi(S_{t+1},A_{t+1})\)입니다. 조건부 기댓값의 반복 법칙(tower property)으로 \(G_{t+1}\) 자리를 \(q_\pi(S_{t+1},A_{t+1})\)로 바꿀 수 있습니다(Markov 환경·Markov 정책이라서 가능). 정리하면 두 논리가 겹쳐 있습니다. ① 미래 누적보상의 기댓값을 다음 상태-행동의 Q로 표현한다. ② 다음 행동에 대한 확률 가중합을 바깥 \(\mathbb E\)로 흡수한다.
Part 1 · MDP
Grid world: 강화학습 문제의 생김새 p.5–7
필기 첫 줄: “강화학습을 적용할 수 있는 문제는 모두 이(MDP)를 만족해야 한다.” 그 MDP를 가장 작은 장난감 세계로 먼저 봅니다.
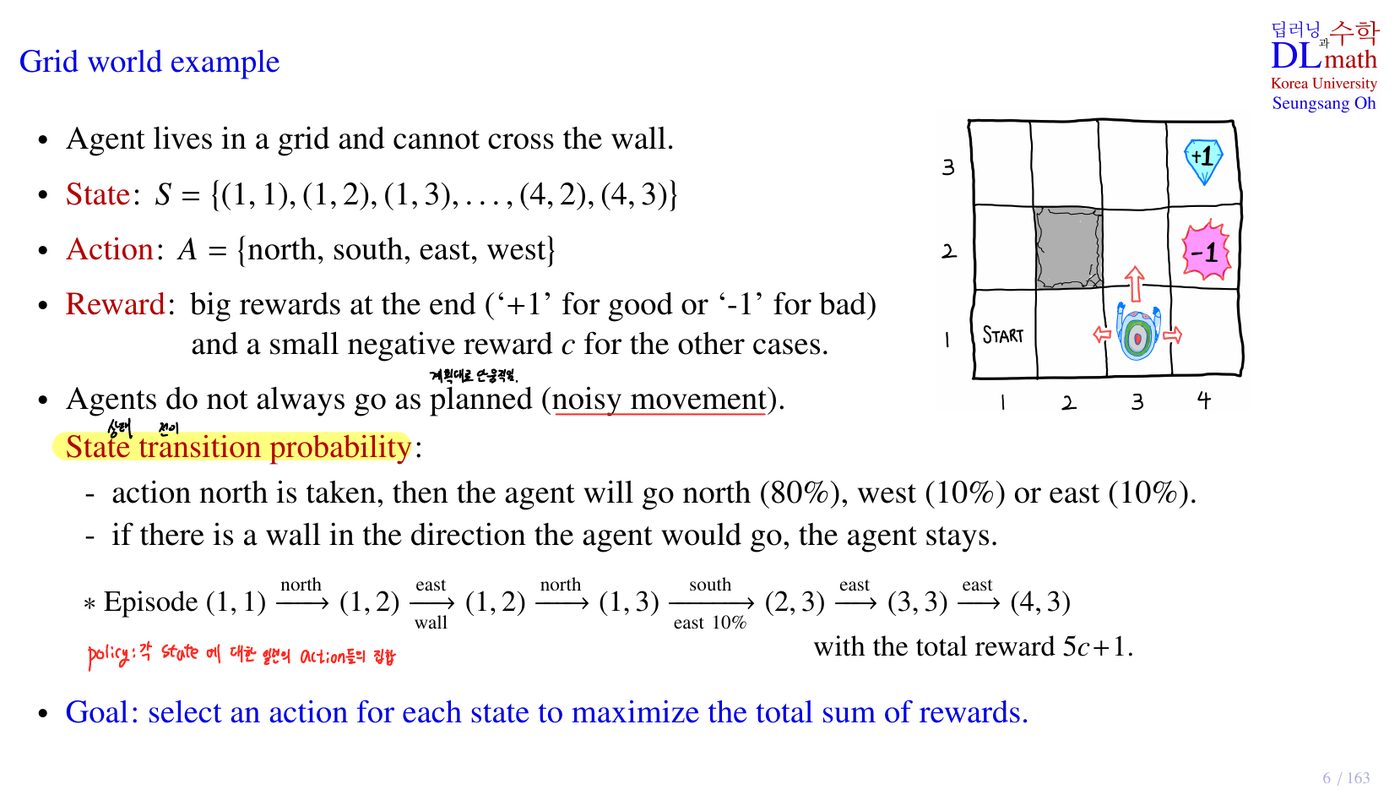
에이전트는 4×3 격자 위를 움직이고 벽(회색 칸)은 지나갈 수 없습니다. 강화학습 문제를 이루는 재료가 여기 모두 있습니다.
- State \(S=\{(1,1),(1,2),\dots,(4,3)\}\): 에이전트가 있을 수 있는 칸.
- Action \(A=\{\text{north, south, east, west}\}\).
- Reward: 끝에 큰 보상(+1 좋음, −1 나쁨), 그 밖의 모든 이동에는 작은 음의 보상 \(c\). (\(c<0\)이면 “빨리 끝내라”는 압박이 됩니다.)
- State transition probability: 계획대로 움직이지 않습니다(noisy movement). north를 고르면 80%는 north, 10%씩 west/east로 미끄러집니다. 벽 쪽이면 제자리.
슬라이드의 에피소드 예: (1,1) →north→ (1,2) →east(벽이라 제자리)→ (1,2) →north→ (1,3) →south(10%로 east로 미끄러짐)→ (2,3) →east→ (3,3) →east→ (4,3). 이동 5번(+c씩) 후 +1에 도착했으므로 total reward = \(5c+1\).
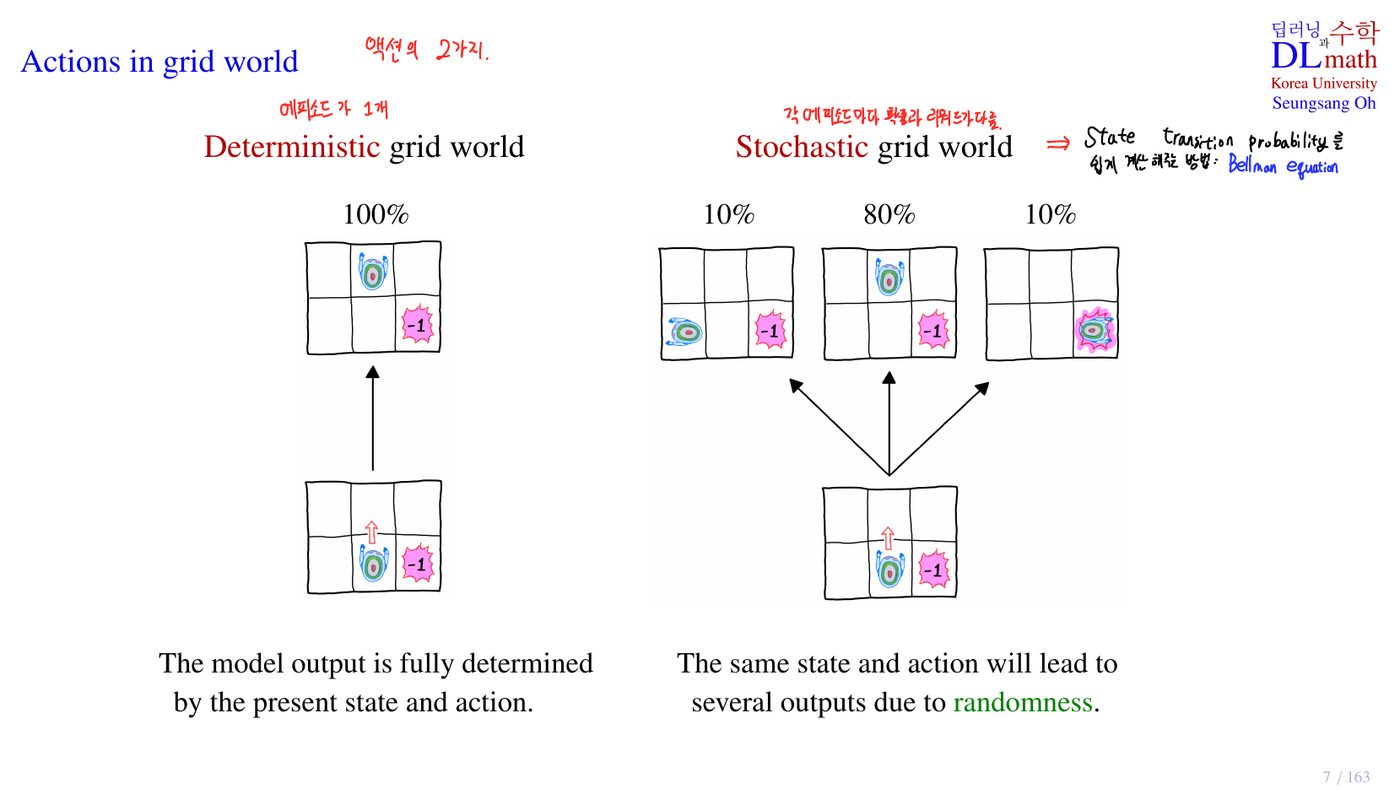
Deterministic grid world
같은 상태·같은 action이면 결과가 100% 정해집니다(“The model output is fully determined by the present state and action”). 필기: 에피소드가 1개.
Stochastic grid world
같은 상태·같은 action이어도 randomness 때문에 결과가 여러 개입니다(10% / 80% / 10%). 그래서 결과를 확률로 다뤄야 하고, 이 계산을 쉽게 해 주는 도구가 Bellman equation입니다(필기).
Markov property와 Markov process p.8
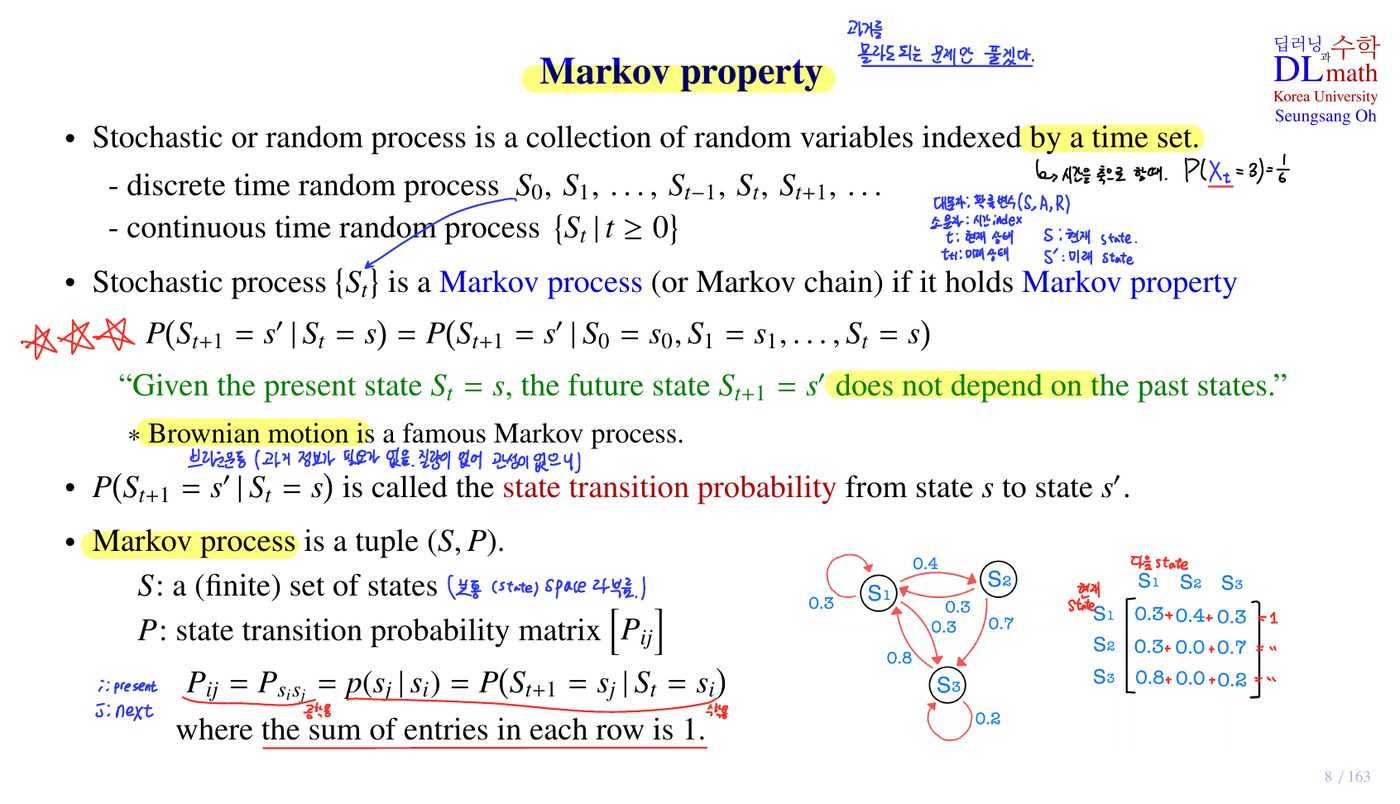
- Stochastic (random) process: 시간 집합으로 인덱스된 확률변수들의 모음. 이산 시간이면 \(S_0,S_1,\dots,S_t,S_{t+1},\dots\), 연속 시간이면 \(\{S_t|t\ge0\}\). 대문자 \(S_t\)는 확률변수, 소문자 \(s\)는 그 값입니다(필기: \(t\)는 현재, \(t+1\)은 미래 시점; \(s\)는 현재 state, \(s'\)는 미래 state).
- \(\{S_t\}\)가 Markov property를 만족하면 Markov process(Markov chain)입니다.
“Given the present state \(S_t=s\), the future state \(S_{t+1}=s'\) does not depend on the past states.” 현재만 알면 과거가 더 이상 정보를 주지 않는다는 뜻입니다. 필기처럼 “과거를 몰라도 되는 문제면 좋겠다”가 이 성질의 의미이고, 이 덕분에 문제를 한 단계씩 재귀적으로 쪼갤 수 있습니다(Bellman equation). 대표 예: Brownian motion(브라운 운동, 과거 정보가 필요 없음: 위치·속도의 이전 기록 없이 현재로 결정).
체스는 지금 판 모양만 보면 다음 수를 고를 수 있습니다(어떤 순서로 이 판이 됐는지는 상관없음) → Markov. 블랙잭에서 “지금 손에 든 카드”만 상태로 잡으면 이미 나간 카드에 따라 남은 카드 확률이 달라지므로 Markov가 깨집니다. 이럴 땐 지나간 카드 정보까지 상태에 넣어야 Markov가 됩니다. 상태를 어떻게 정의하느냐가 Markov 여부를 결정합니다.
\(P(S_{t+1}=s'|S_t=s)\)를 \(s\)에서 \(s'\)으로의 state transition probability라고 합니다. Markov process는 tuple \((S,P)\)입니다.
- \(S\): (유한) 상태 집합 (필기: 보통 state space라 부름)
- \(P\): 상태 전이 확률 행렬 \([P_{ij}]\), \(P_{ij}=P_{s_is_j}=p(s_j|s_i)=P(S_{t+1}=s_j|S_t=s_i)\). \(i\)가 현재, \(j\)가 다음 상태이고, 각 행(row)의 합이 1입니다.
| 현재 \ 다음 | \(S_1\) | \(S_2\) | \(S_3\) | 행 합 |
|---|---|---|---|---|
| \(S_1\) | 0.3 | 0.4 | 0.3 | 1 |
| \(S_2\) | 0.3 | 0.0 | 0.7 | 1 |
| \(S_3\) | 0.8 | 0.0 | 0.2 | 1 |
슬라이드 그림의 전이 행렬. 현재 상태가 정해지면 다음 어딘가로는 반드시 가므로 행의 합이 1입니다(열의 합은 1이 아니어도 됩니다 → T/F 단골).
MDP = (S, A, P, R, γ) p.9–10
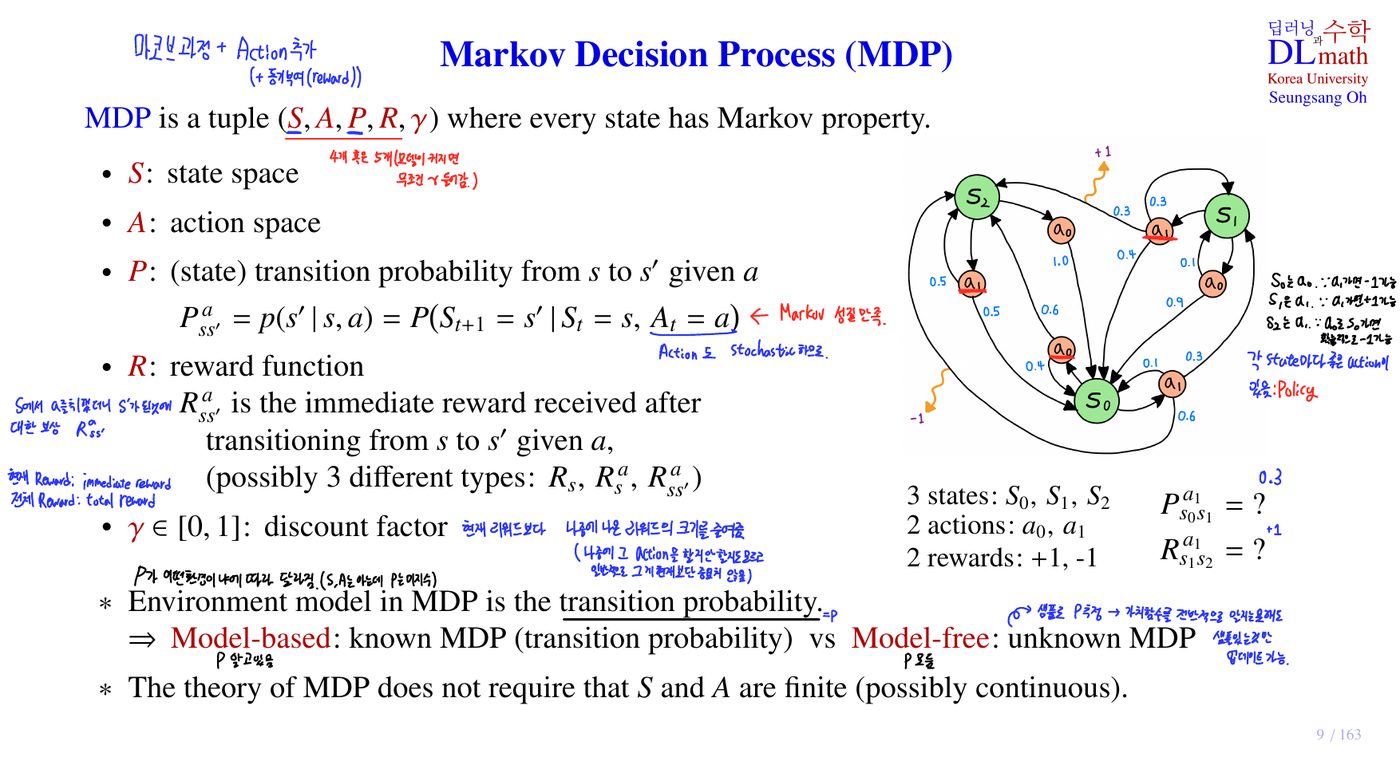
Markov process에 내가 고르는 action과 보상을 더한 것이 MDP입니다. 즉 MDP는 tuple \((S,A,P,R,\gamma)\)이고, 모든 상태가 Markov property를 만족합니다.
- \(S\): state space, \(A\): action space
- \(P\): \(s\)에서 \(a\)를 했을 때 \(s'\)으로 갈 확률. 이제 action이 조건에 들어갑니다. \[P^a_{ss'}=p(s'|s,a)=P(S_{t+1}=s'\,|\,S_t=s,A_t=a)\] (필기: Markov 성질 만족, action도 stochastic하게.)
- \(R\): reward function. \(R^a_{ss'}\)는 \(s\)에서 \(a\)로 \(s'\)에 갔을 때 받는 즉각 보상(immediate reward). 세 가지 형태 \(R_s,\ R^a_s,\ R^a_{ss'}\)가 가능합니다. 필기: 현재 Reward는 immediate reward, 전체 Reward는 total reward.
- \(\gamma\in[0,1]\): discount factor. 필기: 현재 리워드보다 나중에 나온 리워드의 크기를 줄여 줌.
슬라이드 그림(3 states \(S_0,S_1,S_2\), 2 actions \(a_0,a_1\), 2 rewards +1, −1)에서 \(P^{a_1}_{S_0S_1}=0.3\), \(R^{a_1}_{S_1S_2}=+1\)입니다(필기로 채운 답). 초록 원(상태)에서 주황 원(action)으로 가는 선택은 내가 하고, 주황 원에서 나가는 화살표의 확률은 환경이 정합니다.
MDP에서 “환경 모델”이란 전이 확률 \(P\)를 말합니다. ⇒ Model-based: known MDP (P를 앎) vs Model-free: unknown MDP (P를 모름). 필기: 모델을 모르면 P를 추정해서 기대 리워드를 근사해야 하고, 그래서 샘플을 통해 배우는 RL이 필요해집니다. 또 MDP 이론은 \(S\), \(A\)가 유한할 필요가 없습니다(연속 가능).
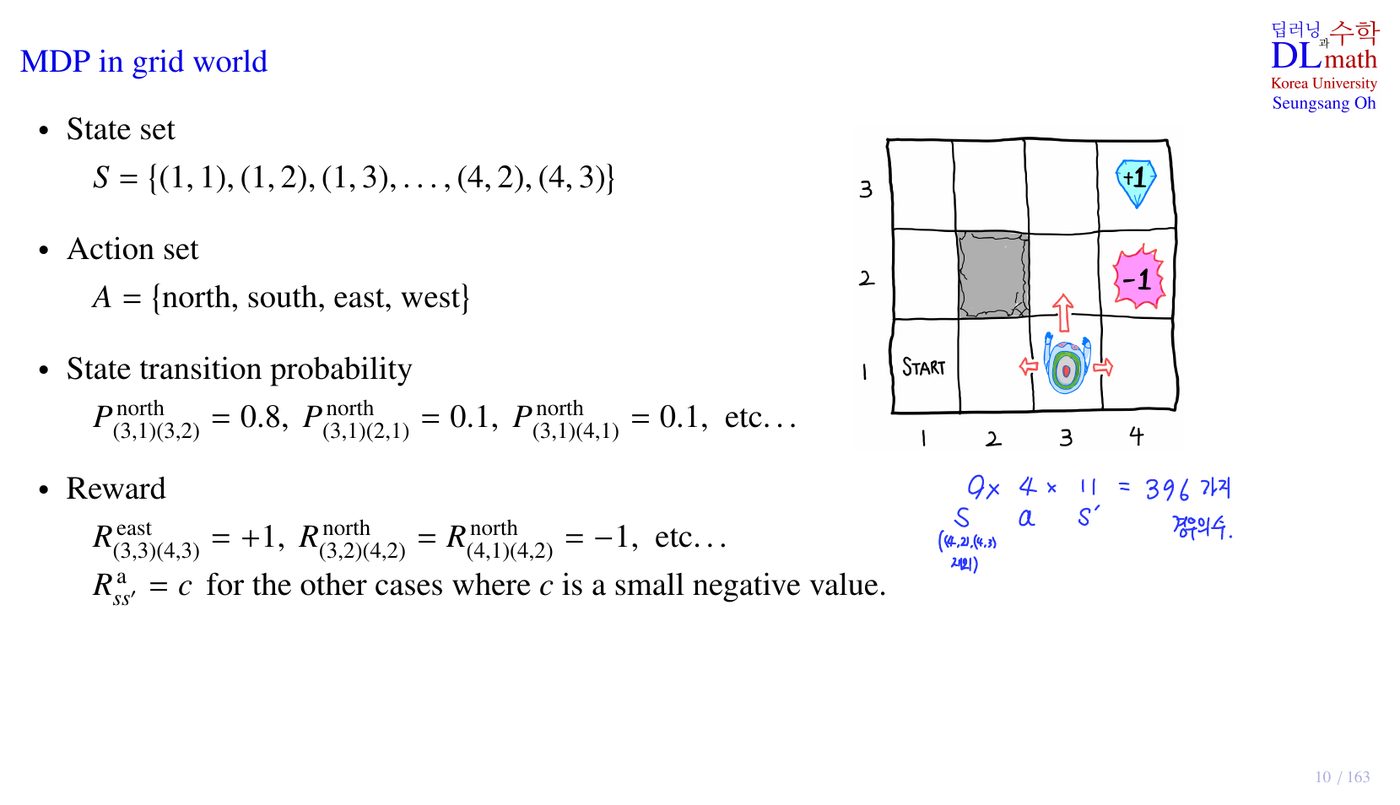
grid world를 MDP 언어로 쓰면: \(P^{\text{north}}_{(3,1)(3,2)}=0.8,\ P^{\text{north}}_{(3,1)(2,1)}=0.1,\ P^{\text{north}}_{(3,1)(4,1)}=0.1\), 보상은 \(R^{\text{east}}_{(3,3)(4,3)}=+1\), \(R^{\text{north}}_{(3,2)(4,2)}=R^{\text{north}}_{(4,1)(4,2)}=-1\), 나머지는 \(R^a_{ss'}=c\). 필기의 “\(9\times4\times11=396\)가지”는 \(P^a_{ss'}\) 표의 칸 수(종료 아닌 상태 × action × 다음 상태)를 센 것입니다. 이 표 전체를 아는 것이 “model을 안다”는 뜻입니다.
Optimal policy: 보상 설계가 행동을 바꾼다 p.11
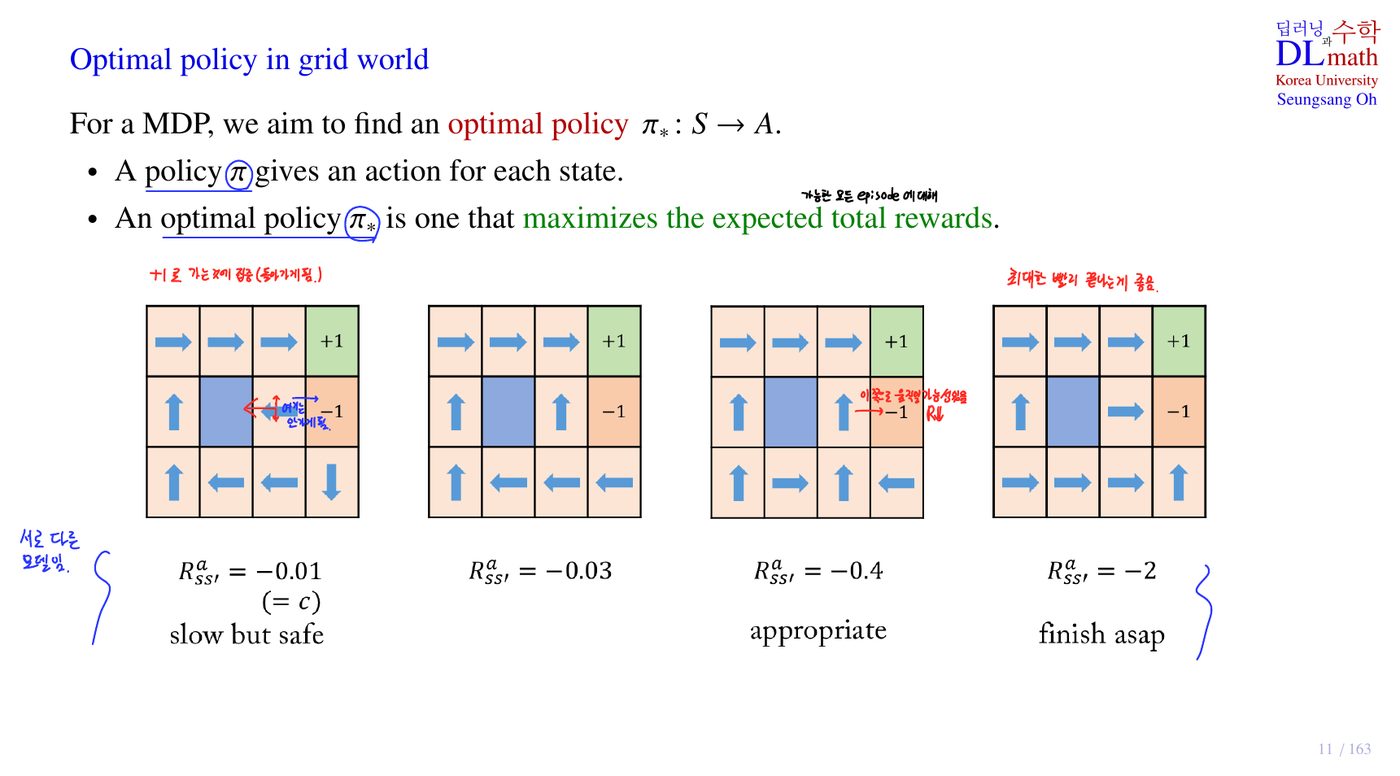
MDP에서 우리가 찾으려는 것은 optimal policy \(\pi_*:S\to A\)입니다. policy는 각 상태에 action을 하나씩 정해 주고, optimal policy는 그중 기대 총보상(expected total rewards)을 최대화하는 policy입니다(필기: 가능한 모든 episode에 대해).
같은 grid world라도 이동마다 받는 작은 보상 \(c=R^a_{ss'}\)만 바꾸면 최적 정책이 완전히 달라집니다(필기: 서로 다른 모델임).
| \(c\) | 이름 | 무슨 일이 일어나나 |
|---|---|---|
| −0.01 | slow but safe | 한 걸음 비용이 거의 없으니 오래 걸려도 됩니다. −1 옆 칸에서도 −1 쪽으로 미끄러질 위험을 피해 벽 쪽(west)을 향하고 먼 길로 돌아갑니다(필기: +1로 가는 게 길어지게 됨). |
| −0.03 | 조금 더 서두릅니다. 위험한 칸 주변 화살표가 바뀌기 시작합니다. | |
| −0.4 | appropriate | 돌아가는 비용이 커져서 −1 옆을 지나가는 위험을 감수하고 짧은 길로 갑니다(필기: 이웃은 위험해도 최단거리로). |
| −2 | finish asap | 한 걸음이 −2라서 −1에 떨어지는 게 오히려 이득입니다. 가장 가까운 종료 칸으로 돌진합니다. −1 바로 옆에서는 일부러 −1로 들어갑니다(필기: 최대한 빨리 끝나는 게 좋음). |
에이전트는 우리가 준 보상을 최대화할 뿐, 우리의 “의도”를 이해하지 않습니다. 그래서 보상 설계(reward shaping)가 곧 행동 설계입니다. 다음 쪽 Reward Hypothesis로 이어집니다.
Reward와 Reward Hypothesis p.12–13
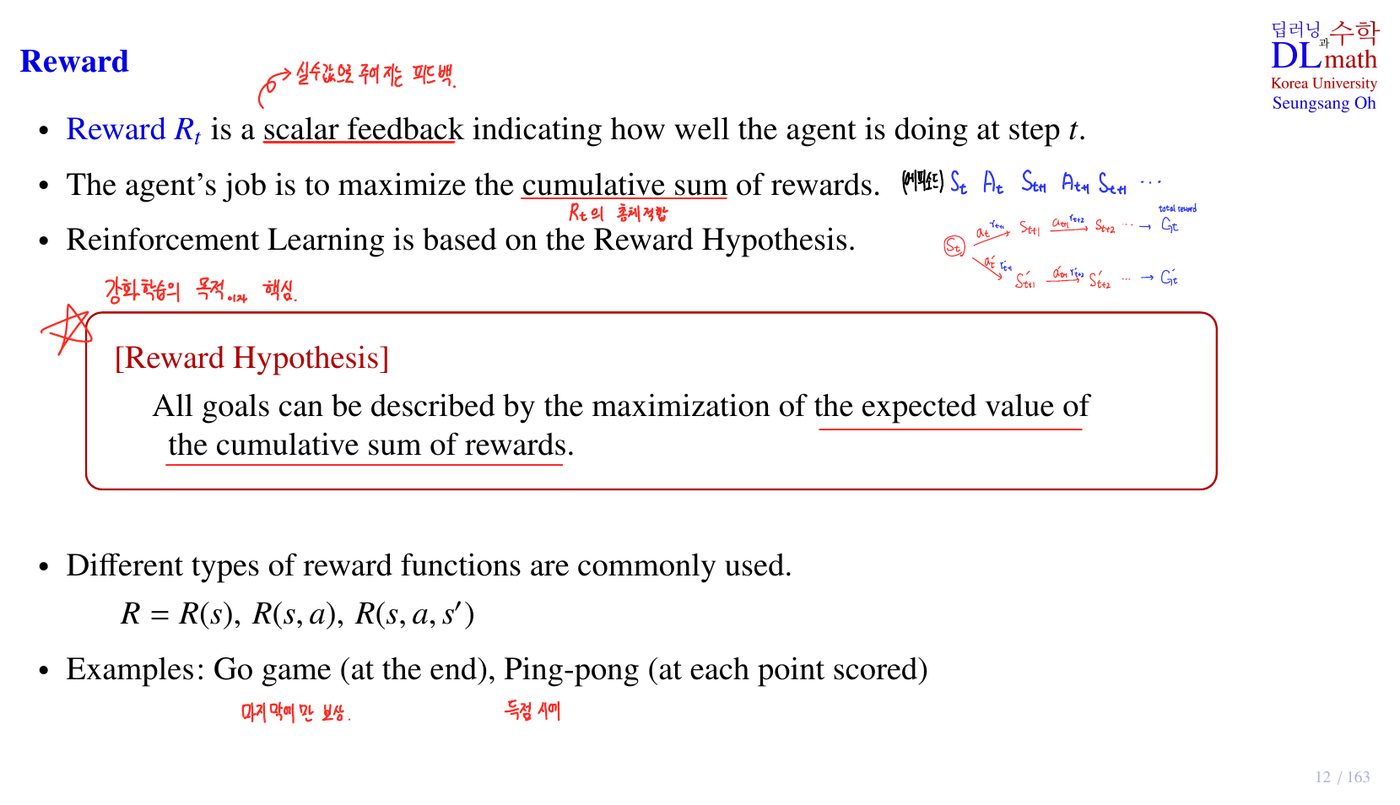
- Reward \(R_t\)는 시점 \(t\)에 에이전트가 얼마나 잘하고 있는지 알려 주는 스칼라 피드백(scalar feedback)입니다(필기: 실수값으로 주어지는 피드백).
- 에이전트가 할 일은 보상의 누적 합(cumulative sum)을 최대화하는 것입니다(필기: \(R_t\)의 총체적 합). 한 번의 보상이 아니라 누적 합이 목표입니다.
- 강화학습은 Reward Hypothesis(보상 가설)를 전제로 합니다.
원문: “All goals can be described by the maximization of the expected value of the cumulative sum of rewards.”
“목표는 무엇이든 보상의 누적합 기댓값 최대화로 표현할 수 있다”는 가정입니다. 바둑의 “이긴다”도, 로봇의 “넘어지지 않고 걷는다”도 보상 숫자로 바꿀 수 있다는 믿음이 강화학습 전체의 전제입니다. 보상 형태는 \(R(s),\ R(s,a),\ R(s,a,s')\) 모두 쓰입니다. 예: 바둑은 대국이 끝날 때만 보상(승/패), 탁구는 득점할 때마다 보상.
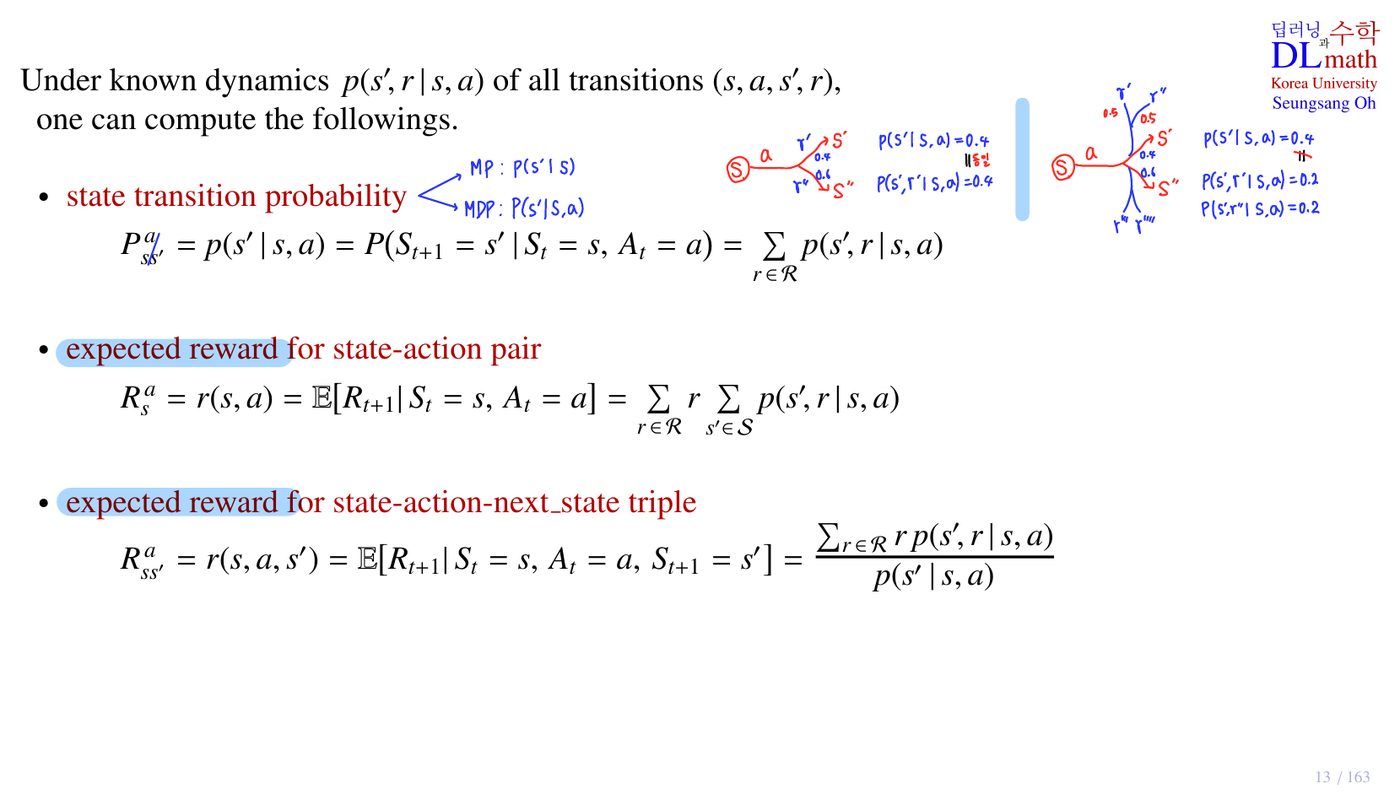
모든 전이 \((s,a,s',r)\)의 dynamics \(p(s',r|s,a)\)를 안다면(known MDP), 나머지는 전부 계산됩니다.
- 첫 식: 같은 \(s'\)에 도착하더라도 보상이 여러 값일 수 있으니, 보상에 대해 다 더하면(주변화) 전이 확률이 됩니다. 필기 예: \(p(s',r'|s,a)=0.2,\ p(s',r''|s,a)=0.2\)이면 \(p(s'|s,a)=0.4\).
- 둘째 식: 보상 값 × 그 보상이 나올 확률(모든 \(s'\)에 대해 합) = 기대 보상.
- 셋째 식: 조건부 기댓값의 정의(결합확률 ÷ 조건의 확률) 그대로입니다.
- 필기: MP는 \(p(s'|s)\), MDP는 \(p(s'|s,a)\). action이 조건에 들어가는 것이 차이입니다.
Return과 discount p.14
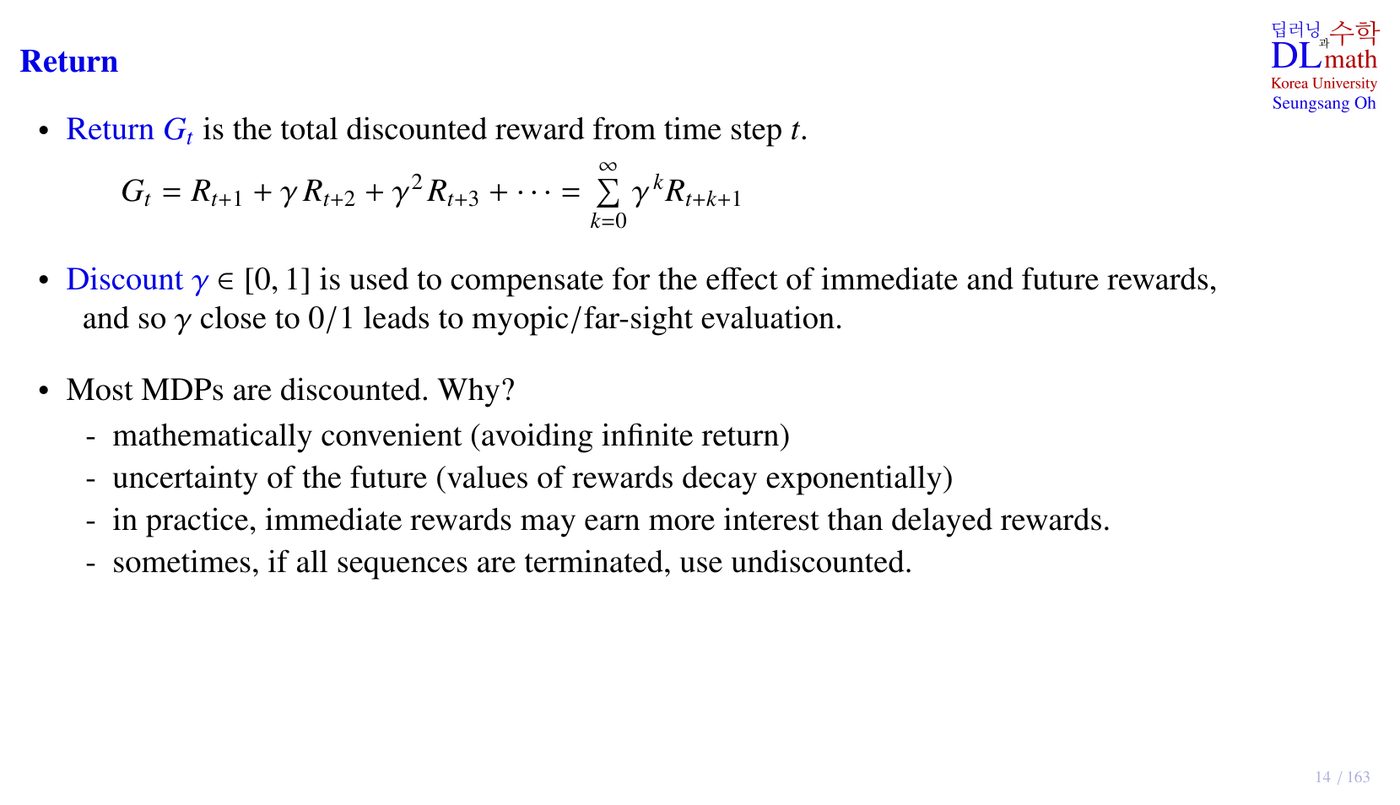
Return \(G_t\)은 시점 \(t\) 이후의 할인된 보상 합입니다. \(t\) 시점의 보상이 \(R_{t+1}\)부터라는 점에 주의하세요(행동 \(A_t\)를 한 결과로 다음 시점에 받는 보상). 앞의 Q&A에서 본 것처럼 \(G_t\)는 확률변수입니다.
- Discount \(\gamma\in[0,1]\)는 즉각 보상과 미래 보상의 비중을 조절합니다. \(\gamma\)가 0에 가까우면 myopic(근시안), 1에 가까우면 far-sight(원시안) 평가.
- 예: \(\gamma=0.9\)이면 10 step 뒤의 보상은 \(0.9^{10}\approx0.35\)배, 50 step 뒤는 \(\approx0.005\)배로 거의 무시됩니다.
Most MDPs are discounted. Why?
- mathematically convenient (avoiding infinite return): 보상이 유계이고 \(\gamma<1\)이면 \(|G_t|\le R_{\max}/(1-\gamma)\)로 유한합니다.
- uncertainty of the future (values of rewards decay exponentially)
- in practice, immediate rewards may earn more interest than delayed rewards (오늘의 100만 원 > 1년 뒤의 100만 원)
- sometimes, if all sequences are terminated, use undiscounted (\(\gamma=1\))
Policy와 기호 정리 p.15–16
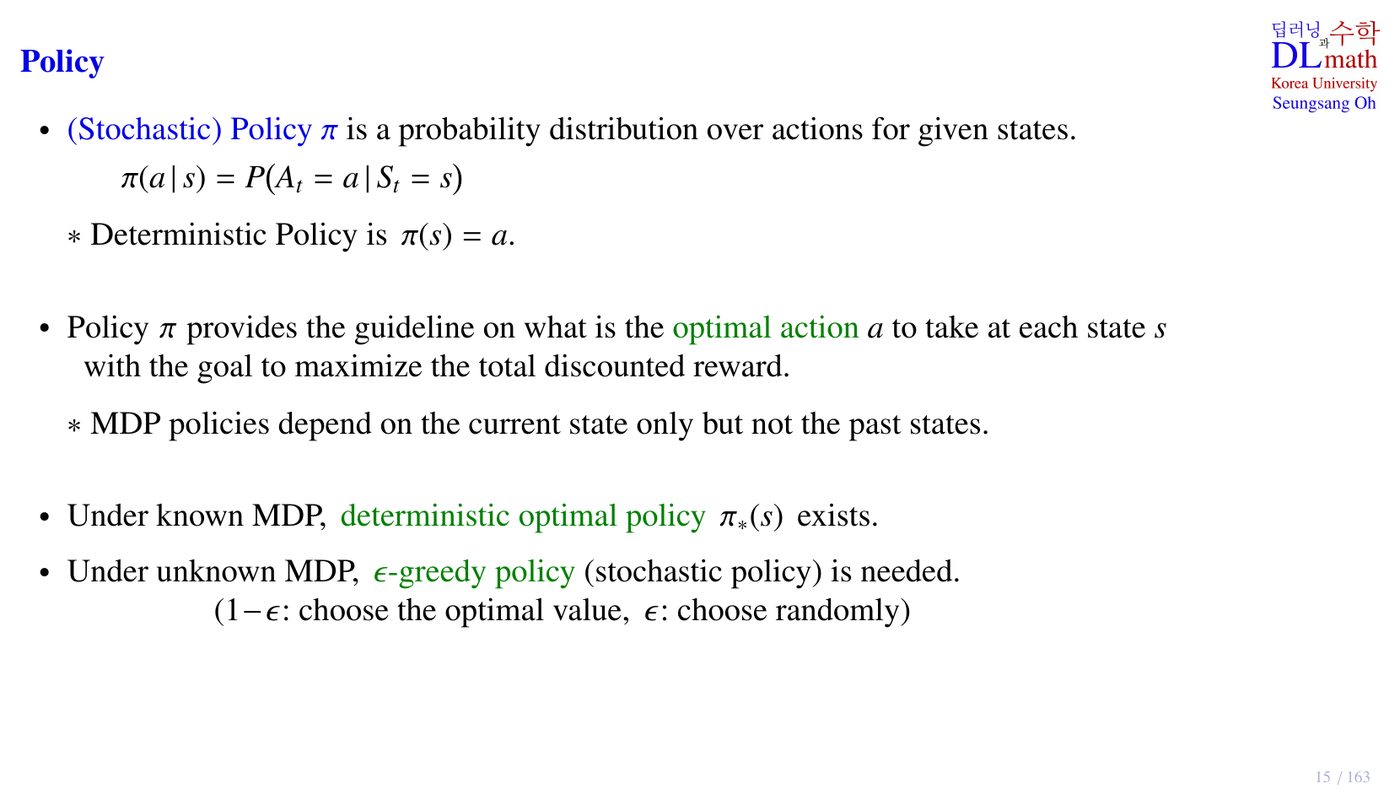
- (Stochastic) Policy \(\pi\)는 주어진 상태에서 action에 대한 확률분포입니다: \(\pi(a|s)=P(A_t=a|S_t=s)\). Deterministic policy는 \(\pi(s)=a\).
- Policy \(\pi\)는 각 상태 \(s\)에서 총 할인 보상을 최대화하려면 어떤 optimal action \(a\)를 해야 하는지 안내합니다.
- MDP 정책은 현재 상태에만 의존하고 과거 상태에는 의존하지 않습니다(Markov 덕분).
- MDP를 알면(known MDP) 결정적 최적 정책(deterministic optimal policy) \(\pi_*(s)\)가 존재합니다.
- MDP를 모르면(unknown MDP) \(\epsilon\)-greedy policy(확률적 정책)가 필요합니다. (\(1-\epsilon\): 최적으로 보이는 것 선택, \(\epsilon\): 무작위 선택.) 모델을 모르면 탐험이 필요하기 때문입니다(47–48쪽).
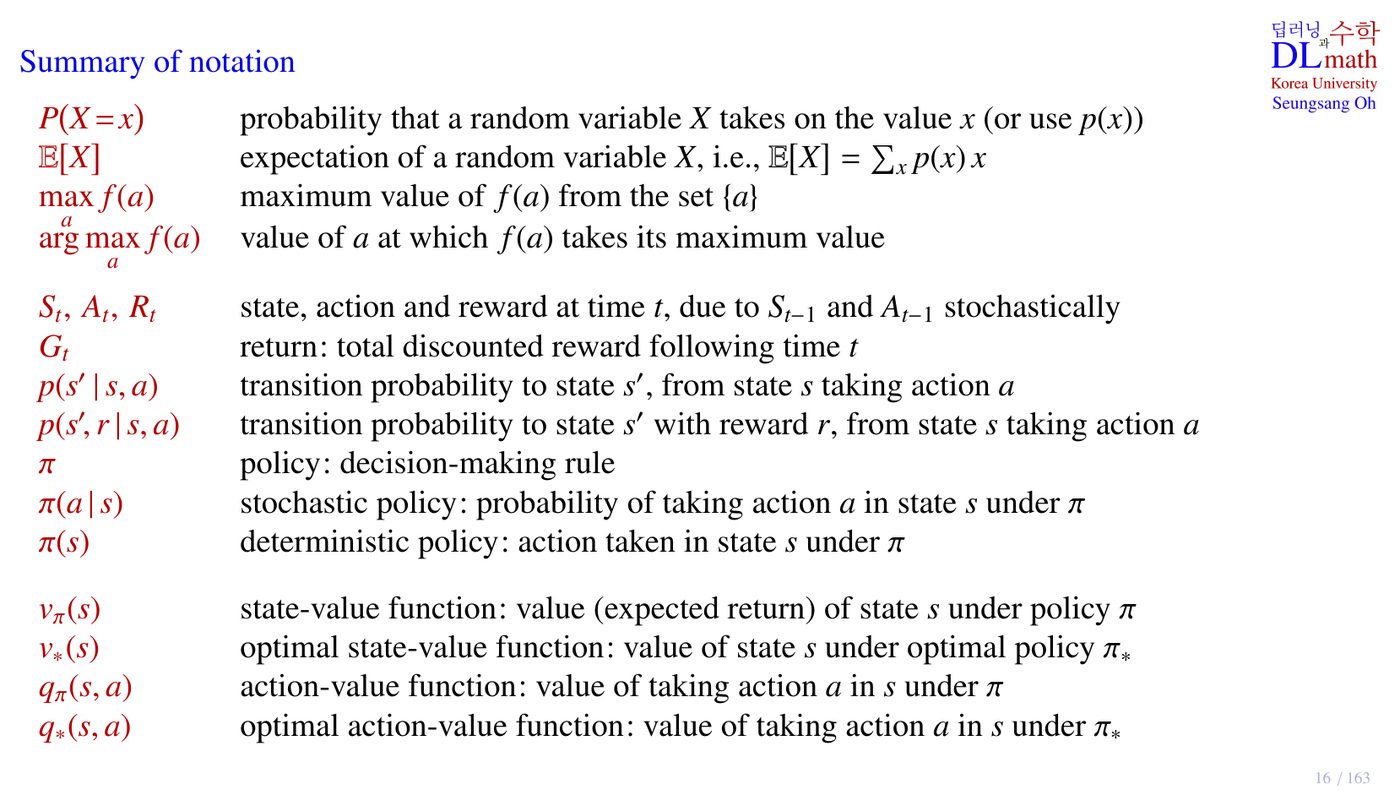
기호표에서 헷갈리기 쉬운 쌍만 짚습니다.
| 기호 | 뜻 | 헷갈리는 짝 |
|---|---|---|
| \(\max_af(a)\) | \(f\)의 최댓값 (숫자) | \(\arg\max_af(a)\): 최댓값을 만드는 \(a\) (action) |
| \(S_t,A_t,R_t\) | 시점 \(t\)의 상태·행동·보상 (확률변수, \(S_{t-1},A_{t-1}\)로부터 확률적으로) | \(s,a,r\): 그 값 |
| \(p(s'|s,a)\) | \(s\)에서 \(a\)로 \(s'\)에 갈 확률 | \(p(s',r|s,a)\): 보상 \(r\)까지 함께 받을 확률 |
| \(\pi(a|s)\) | stochastic policy | \(\pi(s)\): deterministic policy |
| \(v_\pi(s),\ q_\pi(s,a)\) | 정책 \(\pi\)를 따를 때의 가치 | \(v_*(s),\ q_*(s,a)\): 최적 정책 \(\pi_*\)일 때의 가치 |
Part 2 · Bellman Equation
Value functions p.17–18
필기: Bellman equation = (Markov 결정 문제에서 필요한) value function을 찾는 과정. 먼저 value function이 무엇인지부터.
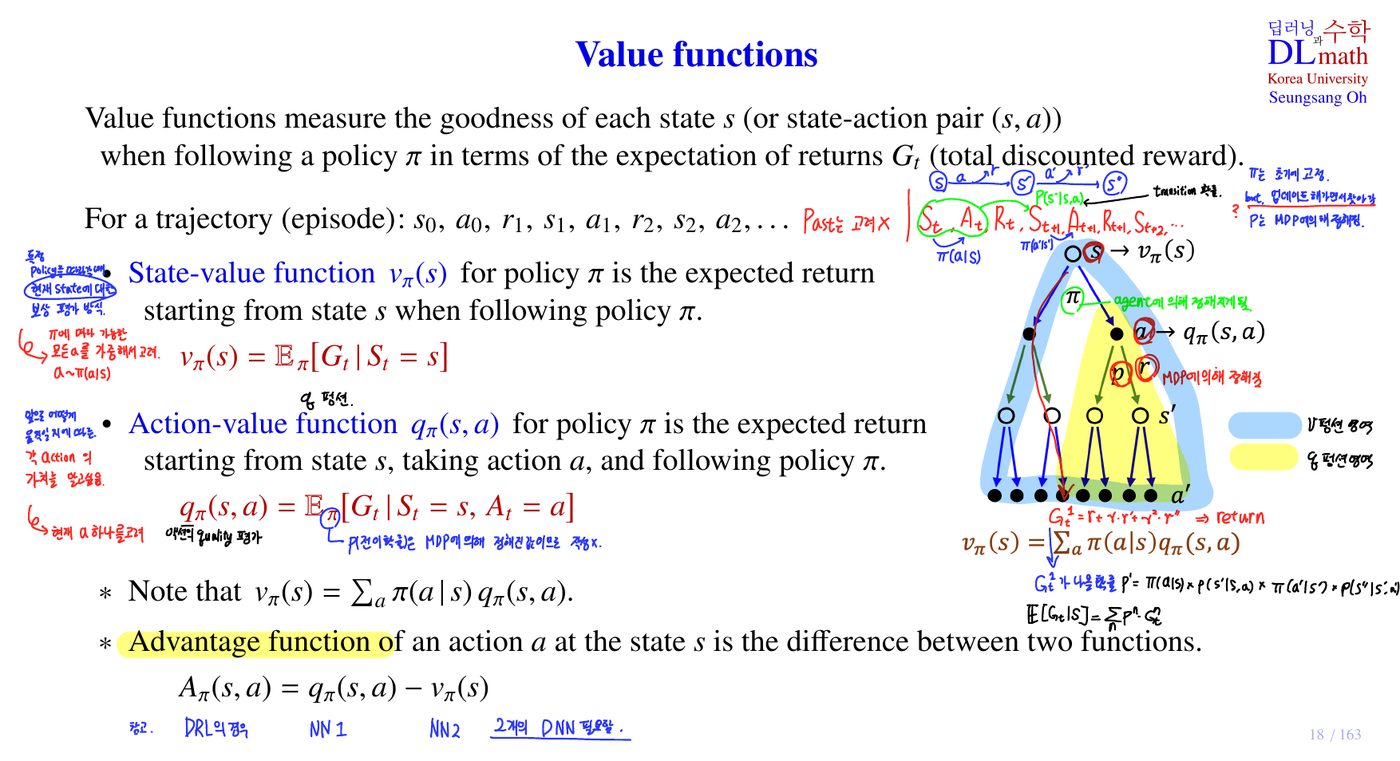
Value function은 정책 \(\pi\)를 따를 때 각 상태 \(s\)(또는 상태-행동 쌍 \((s,a)\))가 얼마나 좋은지를, return \(G_t\)의 기댓값으로 잽니다.
- State-value function \(v_\pi(s)\): \(s\)에서 출발해 \(\pi\)를 따랐을 때의 기대 return. 필기: 정책을 따랐을 때 현재 state에 대한 보상 평가 방식이고, \(\pi\)에 의해 가능한 모든 \(a\)(\(a\sim\pi(a|s)\))를 가중해 고려합니다.
- Action-value function \(q_\pi(s,a)\): \(s\)에서 먼저 \(a\)를 하고 그 뒤 \(\pi\)를 따랐을 때의 기대 return. 필기: 현재 \(a\) 하나를 고정하고 그 action의 가치(quality)를 평가.
- 그림 읽기: 위의 흰 원이 \(s\), 검은 점이 action, 노란 영역이 \(q_\pi(s,a)\)가 보는 범위, 하늘색 전체가 \(v_\pi(s)\)가 보는 범위입니다. \(v\)는 \(\pi\)로 action까지 평균내고, \(q\)는 action을 하나로 고정한 뒤 나머지(환경 p와 이후의 \(\pi\))만 평균냅니다.
Advantage function은 “이 action이 이 상태의 평균보다 얼마나 나은가”입니다. 양수면 평균보다 좋은 action. 필기: 뒤에서 DRL(actor-critic 계열)에서 쓰이며 NN 두 개(\(q\)용, \(v\)용)가 필요해집니다.
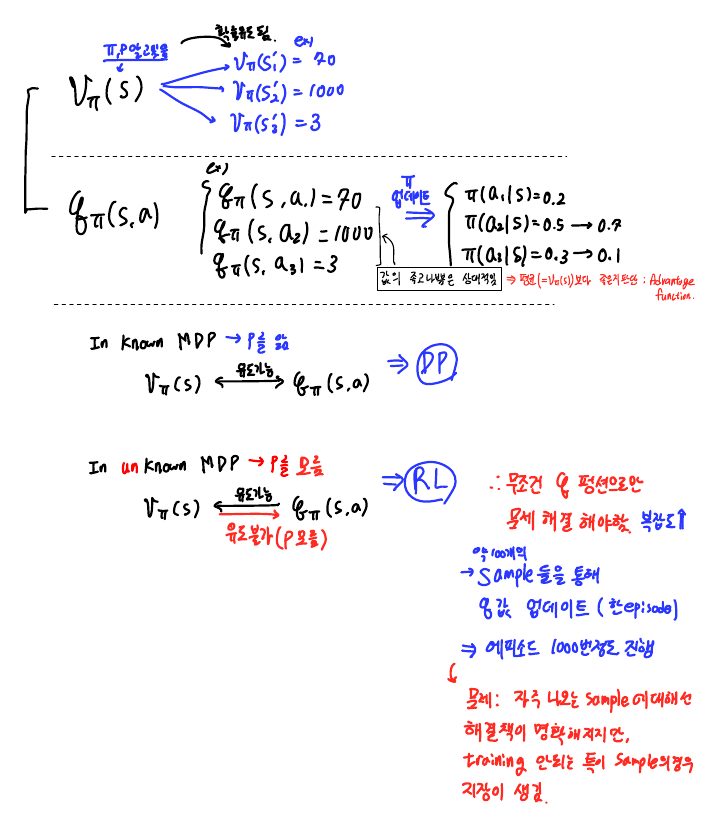
필기 페이지의 핵심을 옮기면:
- \(v_\pi(s)\)는 상태마다 숫자 하나(예: \(v(s_1)=70,\ v(s_2)=1000,\ v(s_3)=3\)), \(q_\pi(s,a)\)는 상태-행동 쌍마다 숫자 하나(예: \(q(s,a_1)=70,\ q(s,a_2)=1000,\ q(s,a_3)=3\)).
- \(q\)를 알면 정책을 바로 고칠 수 있습니다. 예: \(\pi(a_1|s)=0.2,\ \pi(a_2|s)=0.5,\ \pi(a_3|s)=0.3\)이었다면 \(q\)가 가장 큰 \(a_2\)의 확률을 0.7로 올리고 \(a_3\)는 0.1로 내리는 식(\(q-v\)를 보는 것이 advantage function).
- known MDP(P를 앎): \(v_\pi(s)\leftrightarrow q_\pi(s,a)\) 서로 변환 가능 → DP.
- unknown MDP(P 모름): \(v\)에서 \(q\)로 갈 수 없음(P가 필요) → RL은 \(q\)를 직접 써야 하고, 문제가 커지면 샘플을 통해 q값을 업데이트(한 episode씩) → 에피소드 1000번 이상 진행. 문제: 자주 나오는 sample에서는 해결책이 명확해지지만 training 안 된 드문 sample에서는 약점이 생김.
전체 확률의 법칙과 큰 수의 법칙 p.19
Bellman 유도에는 앞의 것이, Monte Carlo에는 뒤의 것이 쓰입니다.
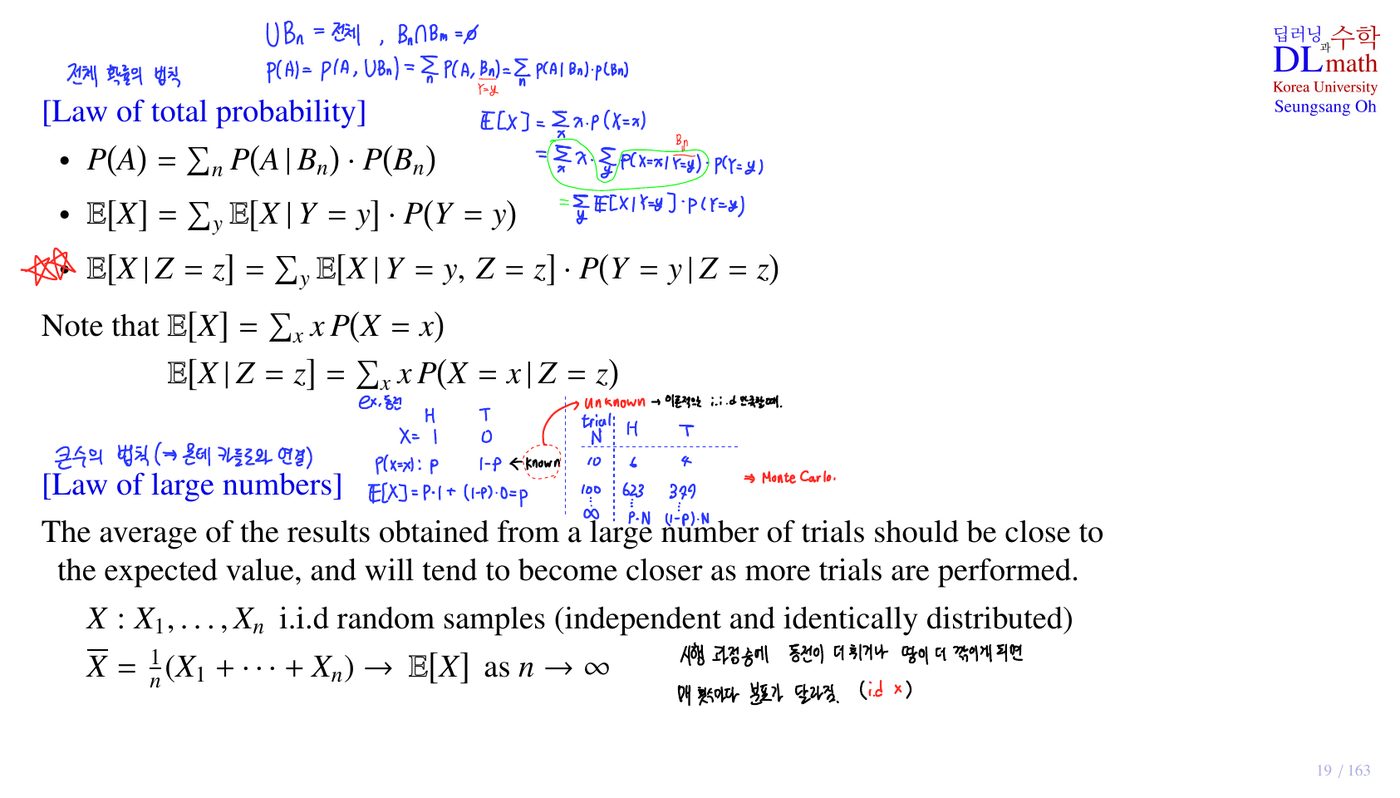
Law of total probability
- 첫 식: 표본공간을 겹치지 않는 조각 \(B_n\)(\(\cup B_n=\)전체, \(B_n\cap B_m=\emptyset\))으로 나누고, 조각별로 계산해서 확률로 가중합합니다.
- 둘째 식은 기댓값 버전입니다. 필기의 증명: \(\mathbb E[X]=\sum_xx\,P(X=x)=\sum_xx\sum_yP(X=x|Y=y)P(Y=y)=\sum_y\mathbb E[X|Y=y]P(Y=y)\).
- ★ 셋째 식이 Bellman 유도의 엔진입니다. 이미 \(Z=z\)라는 조건이 있는 상태에서, 또 다른 변수 \(Y\)로 경우를 나눠 평균내는 것. Bellman에서는 \(Z\)가 “\(S_t=s\)”, \(Y\)가 “\(A_t\)” 또는 “\((S_{t+1},R_{t+1})\)”입니다.
Law of large numbers
시행을 아주 많이 하면 결과의 평균은 기댓값에 가까워지고, 시행을 늘릴수록 더 가까워집니다. \(X_1,\dots,X_n\)이 i.i.d.(서로 독립이고 같은 분포)이면
필기의 동전 예: 앞면 확률을 \(p\)라고 하면 \(\mathbb E[X]=p\cdot1+(1-p)\cdot0=p\). \(p\)를 모르더라도(unknown) 던져 보면 10번에 6/4, 100번에 63/37, … 무한히 던지면 \(pN : (1-p)N\)으로 갑니다. 이것이 Monte Carlo의 원리입니다. 필기 단서: 시행 과정에서 동전이 휘거나 땅이 꺼지는 식으로 매번 분포가 달라지면(i.i.d. 아님) 성립하지 않습니다 → 46쪽의 non-stationary 문제와 constant-α로 이어집니다.
Bellman expectation equation 유도 p.20
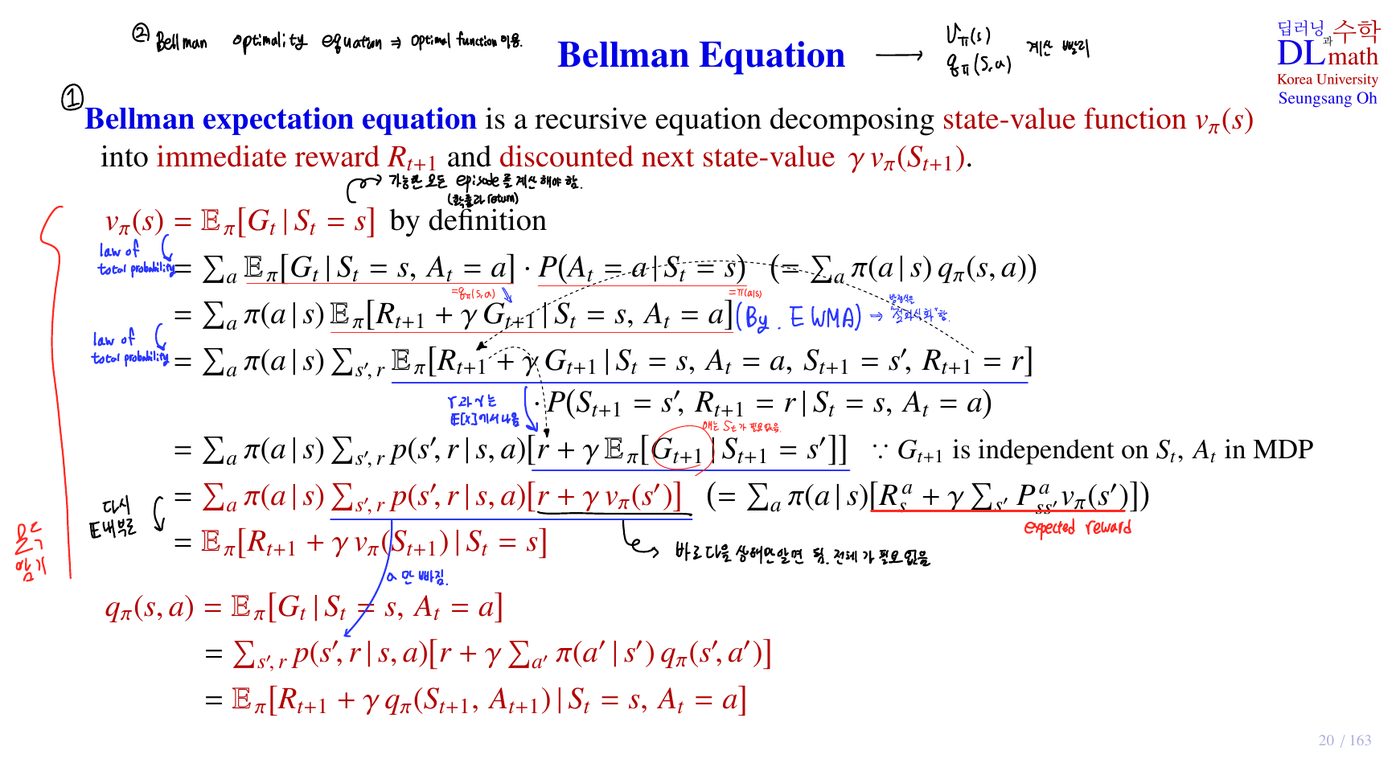
Bellman expectation equation은 state-value function \(v_\pi(s)\)를 즉각 보상(immediate reward) \(R_{t+1}\)과 할인된 다음 상태 가치(discounted next state-value) \(\gamma v_\pi(S_{t+1})\)로 쪼개는 재귀 방정식입니다. 빈칸 문제로 나오기 좋은 문장이라 영어 원문 단어(빨간 글씨)를 그대로 기억해 두세요.
- 넷째 줄에서 조건에 \(R_{t+1}=r\)이 들어가 있으므로 \(R_{t+1}\)은 그냥 \(r\)이 됩니다. 남은 \(\mathbb E[G_{t+1}|\cdots]\)는 Markov property 덕분에 \(S_{t+1}=s'\)만 남기고 나머지 조건을 지울 수 있고, 정의상 \(v_\pi(s')\)입니다(필기: 바로 다음 상태만 알면 됨, 전체가 필요 없음).
- 마지막 줄을 Q&A의 Q3(\(\sum_xP(X=x)f(x)=\mathbb E[f(X)]\))으로 읽으면, 결합확률 \(\pi(a|s)p(s',r|s,a)\)로 가중한 합이 곧 \(\mathbb E_\pi\)입니다.
\(q\) 버전은 첫 action이 이미 정해져 있으므로 바깥 \(\sum_a\pi(a|s)\)가 없고, 대신 다음 상태에서의 action을 \(\sum_{a'}\pi(a'|s')\)로 평균냅니다. 둘째 표기에서 셋째 표기로 가는 논리는 Q&A의 Q4에 있습니다.
Expectation 식에서 Optimality 식으로 p.21
정책 π를 하나 정해 두고 그 정책의 가치를 재는 식이 expectation 식이었습니다. 이제 질문을 바꿉니다. “가장 좋은 정책의 가치는 얼마인가?”
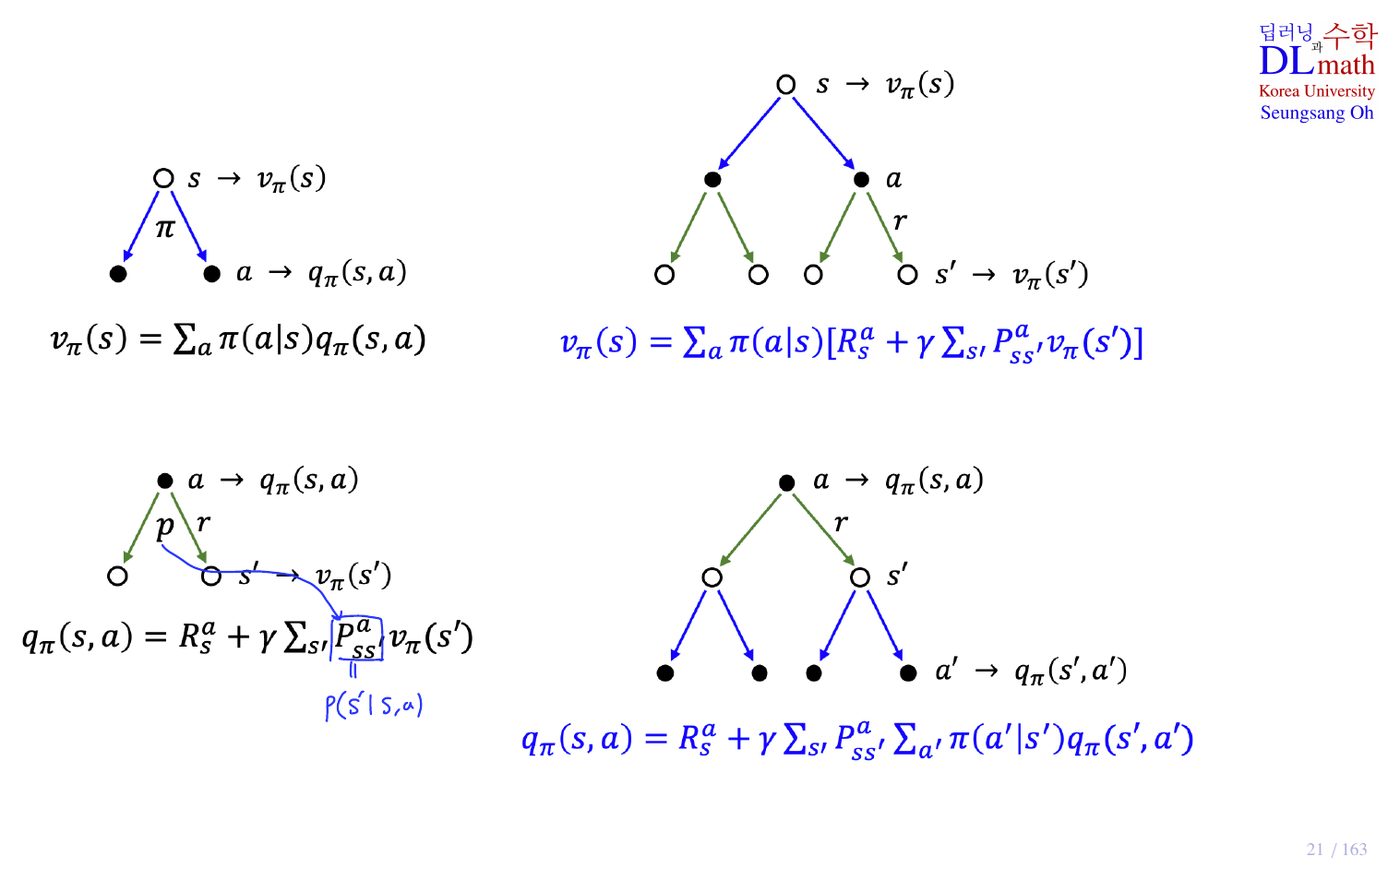
21쪽 그림은 20쪽에서 유도한 expectation 식들을 backup diagram으로 한 장에 모은 것입니다. 앞으로 볼 optimality 식은 이 네 개의 그림에서 딱 한 군데만 바뀝니다. 흰 원(상태 \(s\))에서 검은 점(action \(a\))으로 내려가는 파란 화살표, 즉 “action을 고르는 단계”입니다.
| 단계 | 누가 결정하나 | expectation 식에서 | optimality 식에서 |
|---|---|---|---|
| 상태 \(s\) → action \(a\) | 에이전트 (나의 선택) | \(\sum_a\pi(a|s)\,(\cdot)\): 정책 확률로 평균 | \(\max_a\,(\cdot)\): 가장 좋은 것 하나 |
| action \(a\) → 다음 상태 \(s'\), 보상 \(r\) | 환경 (내 맘대로 안 됨) | \(\sum_{s',r}p(s',r|s,a)\,(\cdot)\) | \(\sum_{s',r}p(s',r|s,a)\,(\cdot)\) 그대로 |
내가 고를 수 있는 곳(action)에서는 평균 대신 최댓값을 고르고, 내가 못 고르는 곳(환경의 전이)에서는 여전히 평균을 낸다. 그것이 optimality 식입니다.
최적 가치 함수와 최적 정책 p.22
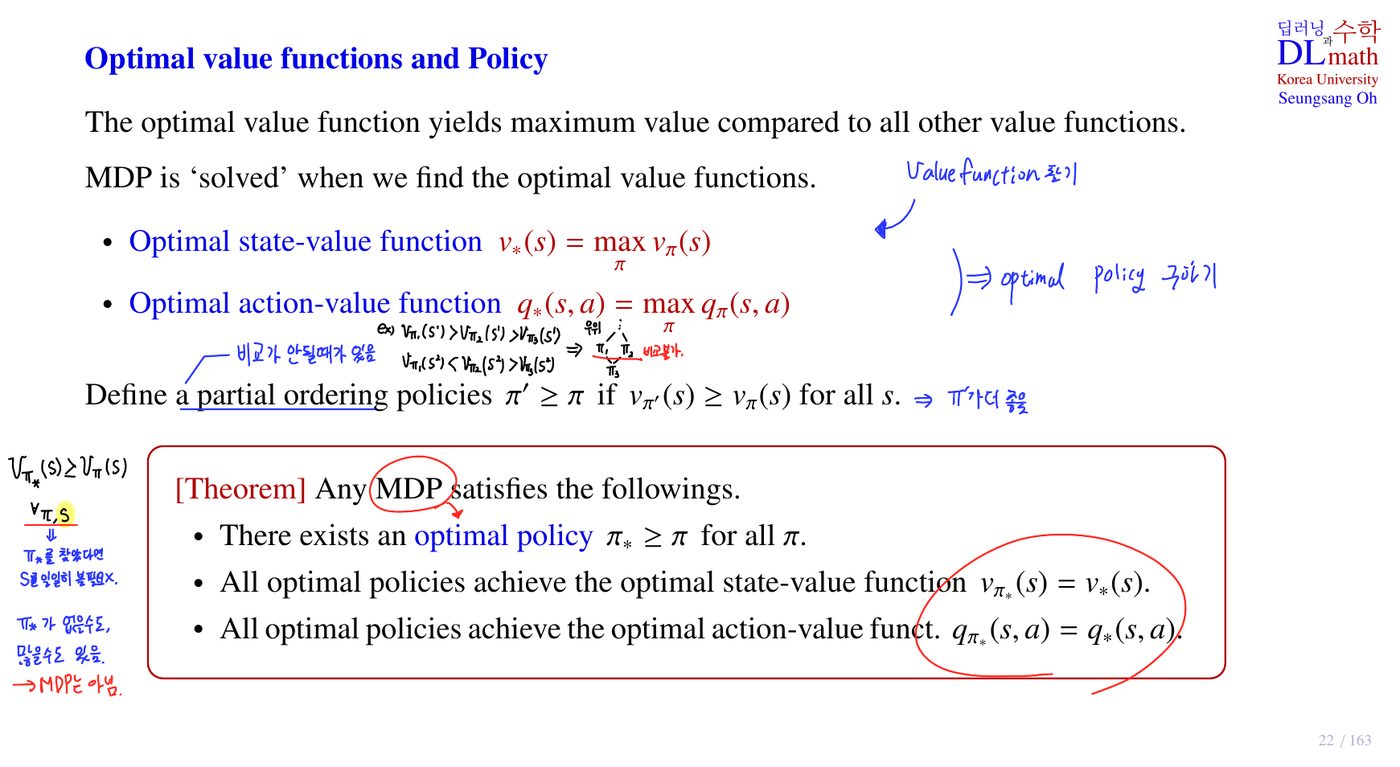
최적 가치 함수(optimal value function)는 가능한 모든 정책의 value function 가운데 가장 큰 값을 주는 함수입니다. 상태마다 “어떤 정책을 쓰든 이보다 더 잘할 수는 없다”는 상한선이라고 보면 됩니다. 그리고 이 최적 가치 함수를 찾으면 MDP를 ‘풀었다(solved)’고 말합니다. 최적 가치만 알면 각 상태에서 그 값을 만드는 action을 고르는 것으로 최적 정책이 바로 나오기 때문입니다(23쪽).
- Optimal state-value function \(v_*(s)\): 세상의 모든 정책을 다 시험해 봤을 때, 상태 \(s\)에서 얻을 수 있는 기대 return의 최댓값.
- Optimal action-value function \(q_*(s,a)\): 상태 \(s\)에서 일단 \(a\)를 하고, 그 뒤로는 가장 잘했을 때의 기대 return.
필기 흐름 그대로입니다. value function을 찾으면(→) optimal policy를 구할 수 있습니다. 그래서 “MDP를 푼다 = \(v_*\) 또는 \(q_*\)를 찾는다”입니다.
정책끼리 크기를 어떻게 비교하나: partial ordering
숫자는 크기 비교가 항상 되지만, 정책은 상태마다 값이 있는 “벡터”라서 비교가 안 될 때가 있습니다(필기: “비교가 안될 때가 있음”). 예를 들어 상태가 두 개일 때
| 정책 | \(v(s_1)\) | \(v(s_2)\) | 비교 |
|---|---|---|---|
| \(\pi_1\) | 5 | 1 | \(s_1\)에선 \(\pi_1\)이, \(s_2\)에선 \(\pi_2\)가 낫다 → 비교 불가 |
| \(\pi_2\) | 3 | 4 | |
| \(\pi_3\) | 6 | 4 | 모든 상태에서 \(\ge\) → \(\pi_3\ge\pi_1\), \(\pi_3\ge\pi_2\) |
그래서 “전체 순서(total order)”가 아니라 “부분 순서(partial order)”입니다.
그런데도 “모두를 이기는 정책”이 있다: Theorem
- 최적 정책이 존재한다. 모든 정책 \(\pi\)에 대해 \(\pi_*\ge\pi\)인 정책 \(\pi_*\)가 있습니다. 즉 어떤 정책과 비교해도, 모든 상태에서 지지 않는 정책이 적어도 하나는 있습니다.
- 모든 최적 정책은 최적 상태 가치에 도달한다. \(v_{\pi_*}(s)=v_*(s)\). 최적 정책을 따르면 각 상태의 가치가 정확히 그 상태에서 가능한 최댓값이 됩니다.
- 모든 최적 정책은 최적 행동 가치에 도달한다. \(q_{\pi_*}(s,a)=q_*(s,a)\). 상태-행동 쌍 기준으로도 마찬가지입니다.
비교가 안 되는 쌍이 있을 수 있는데도, 모든 정책을 모든 상태에서 동시에 이기는 정책이 항상 존재한다는 것이 놀라운 점입니다. 왜 그럴까요?
위 표의 \(\pi_1\)과 \(\pi_2\)를 보세요. \(s_1\)에서는 \(\pi_1\)처럼, \(s_2\)에서는 \(\pi_2\)처럼 행동하는 새 정책을 만들면 두 정책을 모두 이길 수 있을 것 같습니다. MDP에서는 이 “이어 붙이기”가 실제로 됩니다. Markov property 덕분에 각 상태에서의 결정은 과거와 무관하게 그 상태만 보고 내리면 되기 때문입니다. 모든 상태에서 가장 좋은 선택을 모으면 그 정책이 모든 상태에서 최고가 되고, 그것이 \(\pi_*\)입니다. (엄밀한 근거는 35쪽 Policy Improvement Theorem입니다. greedy로 고칠 때마다 모든 상태에서 동시에 좋아집니다.)
- 최적 정책은 여러 개일 수 있습니다. 예를 들어 두 action의 \(q_*\)가 똑같이 최대이면 어느 쪽을 골라도 최적입니다.
- 그래도 최적 가치 \(v_*\), \(q_*\)는 하나뿐입니다. 정리의 두 번째·세 번째 줄이 말하는 것이 이것입니다. 최적 정책이 몇 개든 모두 같은 \(v_*\), \(q_*\)를 냅니다.
- 슬라이드에서 Any MDP에 동그라미가 쳐진 이유: 이 보장은 Markov 구조 덕분입니다. 상태가 과거를 충분히 요약하지 못하는(Markov가 아닌) 문제에서는 “상태별 최선을 이어 붙이기”가 성립하지 않을 수 있습니다.
최적 정책 찾기: q*만 있으면 끝 p.23
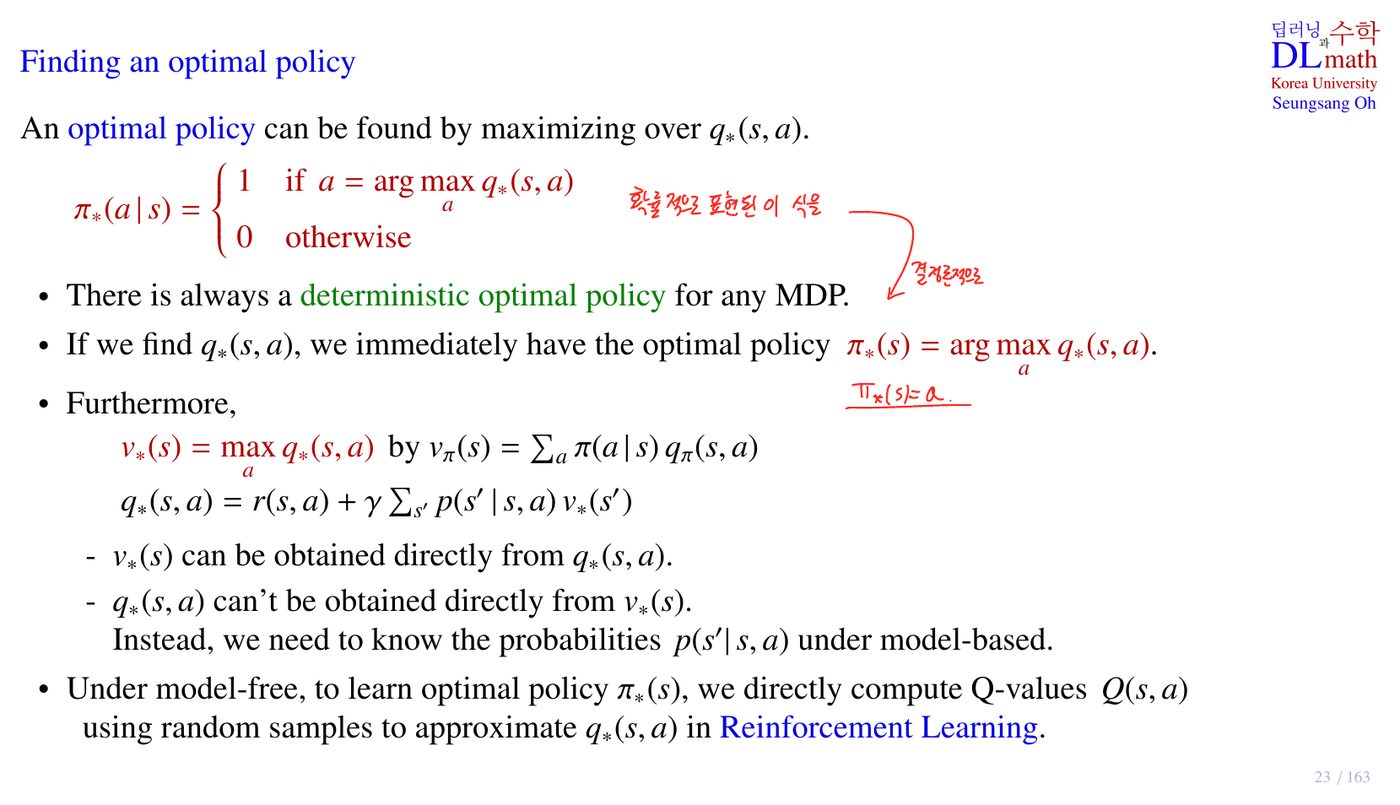
최적 정책은 \(q_*(s,a)\)를 최대화하는 것으로 찾을 수 있습니다. 각 상태에서 \(q_*\)가 가장 큰 action을 고르기만 하면 그것이 최적 정책입니다. \(q_*(s,a)\)가 “지금 \(a\)를 하고 그 뒤로 최선을 다했을 때의 기대 return”이니, 그 값이 가장 큰 \(a\)가 지금 해야 할 최선의 행동이라는 뜻입니다.
왼쪽은 확률 형태(stochastic 표기), 오른쪽은 같은 내용을 결정론적으로 쓴 것입니다(필기). argmax인 action에 확률 1, 나머지에 0이니 사실상 “그 action을 한다”입니다.
- There is always a deterministic optimal policy for any MDP. \(q_*\)의 argmax를 고르면 되므로 확률을 섞을 필요가 없습니다. (unknown MDP에서 ε-greedy를 쓰는 건 탐험 때문이지, 최적 정책이 확률적이라서가 아닙니다.)
- If we find \(q_*(s,a)\), we immediately have the optimal policy \(\pi_*(s)=\arg\max_a q_*(s,a)\).
v*와 q*의 관계: 한쪽 방향만 쉽다
첫 식은 expectation 버전 \(v_\pi=\sum_a\pi(a|s)q_\pi\)에 최적 정책을 넣은 것입니다. \(\pi_*\)는 argmax에만 확률 1을 주므로 \(\sum_a\pi_*(a|s)q_*(s,a)=\max_aq_*(s,a)\)가 됩니다.
q* → v* : 바로 됨
q 표의 각 행에서 최댓값만 읽으면 v입니다. 모델이 필요 없습니다.
v* → q* : 모델이 필요
action \(a\)를 하면 어느 \(s'\)로 몇 % 확률로 가는지(\(p(s'|s,a)\))를 알아야 두 번째 식을 계산할 수 있습니다. model-based에서만 가능합니다.
그래서 마지막 줄이 나옵니다. Under model-free, to learn optimal policy \(\pi_*(s)\), we directly compute Q-values \(Q(s,a)\) using random samples to approximate \(q_*(s,a)\) in Reinforcement Learning. 이것이 Q-learning이 Q를 배우는 이유의 출발점이고, 42쪽(RL은 Q를 평가)과 정확히 같은 이야기입니다.
Bellman optimality equation 유도 p.24
expectation 식을 이해했다면, 유도는 “π 자리에 π*를 넣고 Σπ를 max로 바꾼다” 한 가지만 새로 보면 됩니다.
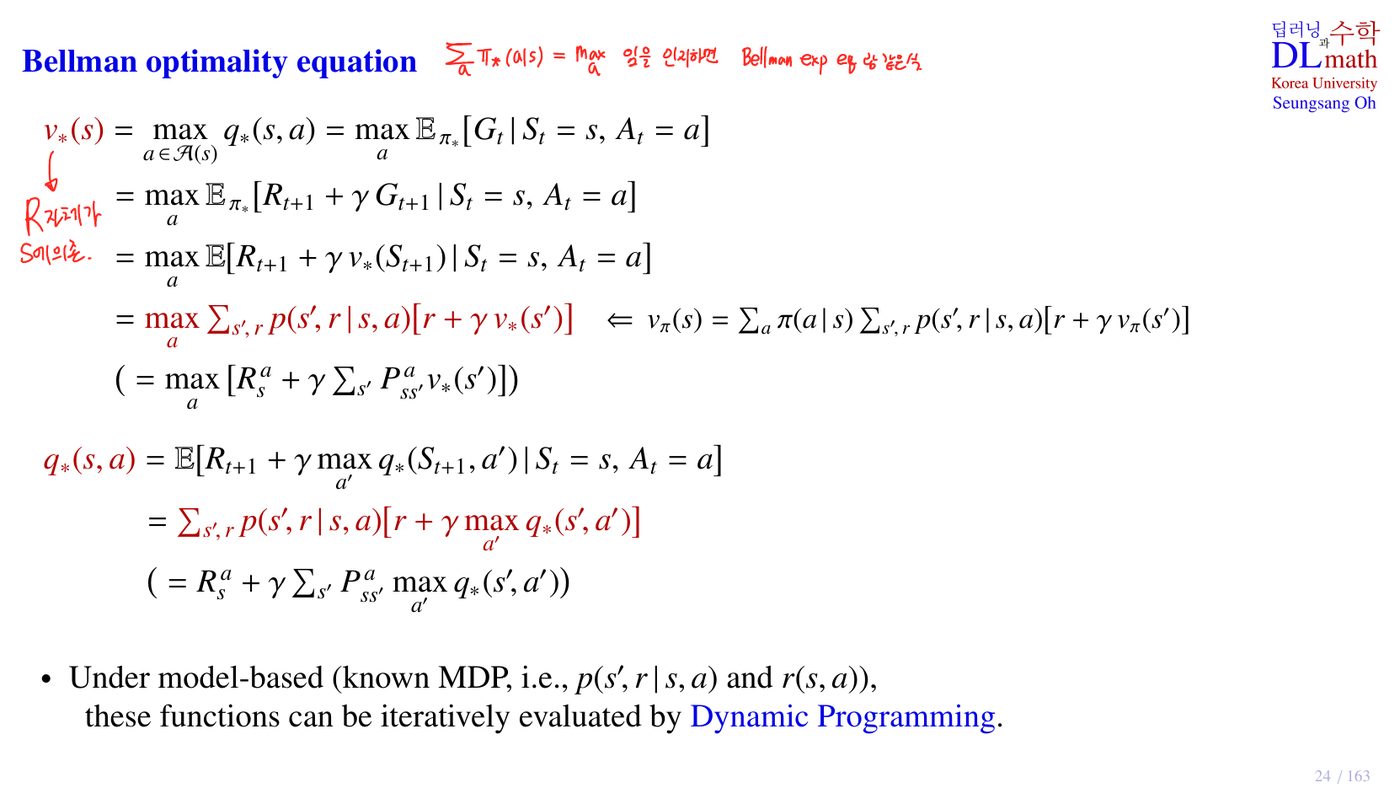
v*에 대한 식, 한 줄씩
- ①이 핵심입니다. expectation 식의 첫 줄은 \(v_\pi(s)=\sum_a\pi(a|s)q_\pi(s,a)\)였습니다. 최적 정책은 argmax에 확률 1을 몰아주므로 이 가중평균이 \(\max_a\)로 바뀝니다.
- ④에서 \(\mathbb E\)의 아래첨자 \(\pi_*\)가 사라지는 이유: \(S_t=s,A_t=a\)가 주어졌으니 \(R_{t+1}\)과 \(S_{t+1}\)을 정하는 건 환경(\(p\))뿐입니다. 정책이 개입하는 부분은 \(G_{t+1}\) 안에 있었는데, 그것을 \(v_*(S_{t+1})\)로 묶었으므로 남은 기댓값은 환경에 대한 것뿐입니다. (expectation 유도에서 “\(G_{t+1}\)은 \(S_t,A_t\)와 독립”을 쓴 것과 같은 자리입니다.)
- 필기 “R 자체가 S에 의존”: \(R_{t+1}\)은 \((s,a)\)에 따라 분포가 달라지므로 max 안쪽에 남아야 합니다. max를 기댓값 밖으로 꺼낼 수 없는 이유입니다.
- ⑤를 expectation 식 \(v_\pi(s)=\sum_a\pi(a|s)\sum_{s',r}p(s',r|s,a)[r+\gamma v_\pi(s')]\)과 나란히 놓으면, \(\sum_a\pi(a|s)\)가 \(\max_a\)로 바뀐 것 말고는 똑같습니다. 슬라이드가 오른쪽에 “\(\Leftarrow v_\pi(s)=\cdots\)”를 적어 둔 이유입니다.
① 평균 내던 자리에서 “고르기”로. \(\sum_a\pi(a|s)q(s,a)\)는 action마다의 값을 정책 확률로 섞은 가중평균입니다. “나는 이 상태에서 30%는 a₁, 70%는 a₂를 한다”면 가치는 둘의 섞인 평균입니다. \(\max_a q(s,a)\)는 섞지 않고 가장 좋은 하나에 확률 1을 몰아준다는 뜻입니다. 최적 정책 \(\pi_*\)가 바로 그런 정책이라서(23쪽), \(\sum_a\pi_*(a|s)q_*(s,a)=\max_aq_*(s,a)\)가 됩니다. 새로운 연산이 생긴 게 아니라, 특별한 정책 하나를 대입한 결과입니다.
② 평균은 최댓값을 넘을 수 없다. 어떤 \(\pi\)든 \(\sum_a\pi(a|s)q(s,a)\le\max_aq(s,a)\)입니다(가중치 합이 1인 평균 ≤ 최댓값). 확률을 나쁜 action에 조금이라도 나눠 주면 그만큼 손해이고, 손해가 0이 되려면 최댓값 action에만 확률을 줘야 합니다. 그래서 “최적 = max”입니다. 이 부등식이 35쪽 Policy Improvement Theorem과 48쪽 ε-greedy 증명에서 쓰인 바로 그 부등식입니다.
③ 숫자로. \(q(s,a_1)=10,\ q(s,a_2)=4\). 정책이 50:50이면 \(0.5(10)+0.5(4)=7\), 90:10이면 \(9.4\), 100:0이면 \(10=\max\). 정책을 바꿔 가며 평균을 키워 나가면 끝에서 max에 닿습니다.
④ max는 나의 선택에만 붙는다. 환경 쪽 \(\sum_{s',r}p(s',r|s,a)\)는 그대로 남습니다. 환경은 내가 고를 수 없으니 여전히 평균을 냅니다. “통제 가능한 것은 최선을 고르고, 통제 불가능한 것은 기댓값을 취한다”가 Bellman optimality의 정체입니다.
q*에 대한 식
읽는 법: action \(a\)는 이미 정해졌으니 바로 환경이 움직입니다(Σp). 다음 상태 \(s'\)에 도착하면 그때 다시 내가 고를 차례이므로 max가 나옵니다. 식 안의 순서가 “환경 평균 → 나의 max”입니다. 앞의 \(v_*\) 식은 “나의 max → 환경 평균” 순서였습니다. 출발점이 상태냐 action이냐의 차이일 뿐입니다.
\(q_*(s,a)=\mathbb E[R_{t+1}+\gamma\max_{a'}q_*(S_{t+1},a')]\)에서 기댓값을 샘플 하나로 바꾸면 Q-learning target \(R_{t+1}+\gamma\max_aQ(S_{t+1},a)\)이 됩니다(51쪽). 그래서 “Q-learning directly learns \(Q^*\) by using Bellman optimality equation”입니다.
expectation 식과 결정적으로 다른 점: max 때문에 비선형
expectation 식은 \(v_\pi\)에 대해 선형입니다. 상태가 \(n\)개면 미지수 \(n\)개짜리 연립일차방정식 \(v_\pi=R^\pi+\gamma P^\pi v_\pi\)이고, 원리적으로는 \(v_\pi=(I-\gamma P^\pi)^{-1}R^\pi\)로 한 번에 풀 수 있습니다. optimality 식에는 \(\max\)가 들어 있어 비선형이고, 이런 닫힌 형태의 해가 없습니다. 그래서 반복해서 근사하는 방법이 필요합니다.
- Under model-based (known MDP, i.e., \(p(s',r|s,a)\) and \(r(s,a)\)), these functions can be iteratively evaluated by Dynamic Programming → Value Iteration(30쪽)은 바로 이 \(v_*\) 식을 반복 대입하는 것입니다.
- model-free에서는 샘플로 근사합니다 → Q-learning.
Backup diagram으로 나란히 보기 p.25
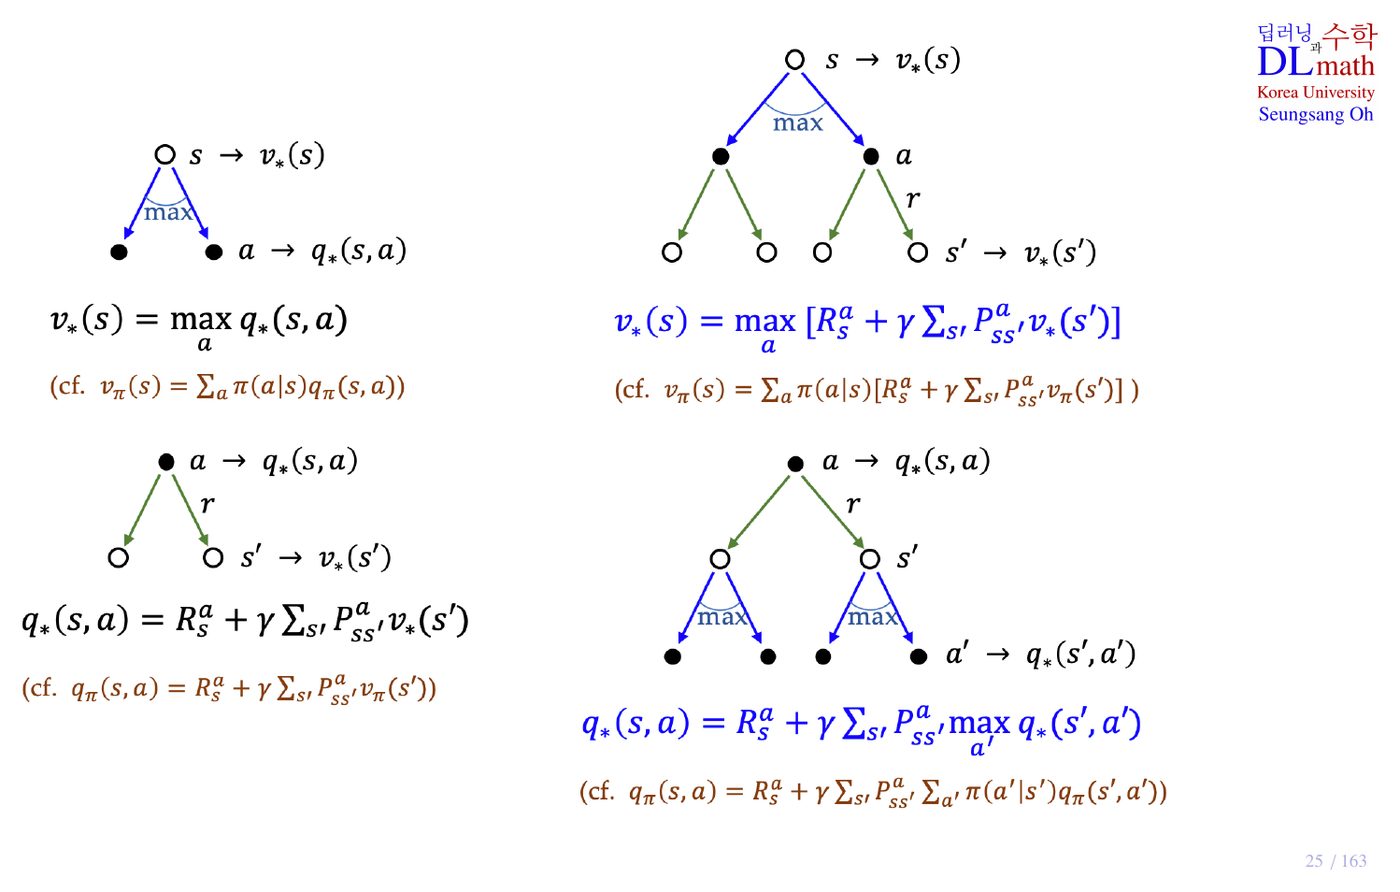
21쪽 그림과 비교하면 흰 원 → 검은 점 가지에 “max” 호가 붙은 것만 다릅니다. 갈색 (cf.) 식이 각각 대응하는 expectation 식입니다.
| 그림 | optimality | expectation (cf.) |
|---|---|---|
| s → a (한 층) | \(v_*(s)=\max_aq_*(s,a)\) | \(v_\pi(s)=\sum_a\pi(a|s)q_\pi(s,a)\) |
| a → s′ (한 층) | \(q_*(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}v_*(s')\) | \(q_\pi(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}v_\pi(s')\) |
| s → a → s′ (두 층) | \(v_*(s)=\max_a[R^a_s+\gamma\sum_{s'}P^a_{ss'}v_*(s')]\) | \(v_\pi(s)=\sum_a\pi(a|s)[R^a_s+\gamma\sum_{s'}P^a_{ss'}v_\pi(s')]\) |
| a → s′ → a′ (두 층) | \(q_*(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}\max_{a'}q_*(s',a')\) | \(q_\pi(s,a)=R^a_s+\gamma\sum_{s'}P^a_{ss'}\sum_{a'}\pi(a'|s')q_\pi(s',a')\) |
두 번째 줄(a → s′ 한 층)은 max가 없습니다. 이 층에는 내가 고르는 단계가 없고 환경만 움직이기 때문입니다. 그래서 \(q_*\)와 \(q_\pi\)의 한 층짜리 식은 모양이 똑같고, 안에 들어가는 값만 \(v_*\)냐 \(v_\pi\)냐가 다릅니다.
두 층짜리 식 두 개만 외우면 나머지는 잘라 쓰면 됩니다. 쓰는 순서: ① 시작점이 상태면 맨 앞에 \(\max_a\), action이면 \(R^a_s+\gamma\sum_{s'}P^a_{ss'}\)부터. ② 다음 층으로 내려갈 때 “내가 고르는 층 = max, 환경 층 = \(\sum P\)”. ③ 맨 끝에 \(v_*(s')\) 또는 \(q_*(s',a')\).
robot car로 검산해 보기 (γ = 0.9)
31쪽 robot car의 결정적 정책은 4개뿐입니다(각 상태에서 slow/fast). 각 정책의 \(v_\pi\)를 expectation 식으로 정확히 풀면:
| 정책 π (cool / warm) | \(v_\pi(\text{cool})\) | \(v_\pi(\text{warm})\) | |
|---|---|---|---|
| slow / slow | 10 | 10 | |
| slow / fast | 10 | −10 | |
| fast / fast | −4.55 | −10 | |
| fast / slow | 15.5 | 14.5 | π* · 모든 상태에서 최대 |
fast / slow가 cool에서도 warm에서도 가장 큽니다. 22쪽 정리 그대로 “모두를 모든 상태에서 이기는” 정책이고, 따라서 \(v_*(\text{cool})=15.5,\ v_*(\text{warm})=14.5\)입니다. 이 값이 Bellman optimality equation을 정말 만족하는지 확인해 봅니다.
양변이 일치합니다(\(v_*\)를 오른쪽에 넣어 계산한 값이 다시 \(v_*\)). 그리고 q*를 계산할 때 전이 확률 0.5, 1.0을 썼다는 점을 보세요. 23쪽의 “v*에서 q*를 얻으려면 p가 필요하다”가 바로 이것입니다. 반대로 q* 네 개가 주어지면 max만 취해서 v*와 π*를 바로 얻습니다.
31쪽 Value Iteration 위젯을 γ = 0.9로 끝까지 돌리면 이 15.5, 14.5에 도착합니다. VI는 이 optimality 식을 반복 대입해서 푸는 방법이기 때문입니다.
Part 3 · Dynamic Programming
Value Iteration p.30
Bellman optimality equation의 등호(=)를 대입 기호(←)로 바꾸고, 수가 더 이상 안 변할 때까지 반복합니다.
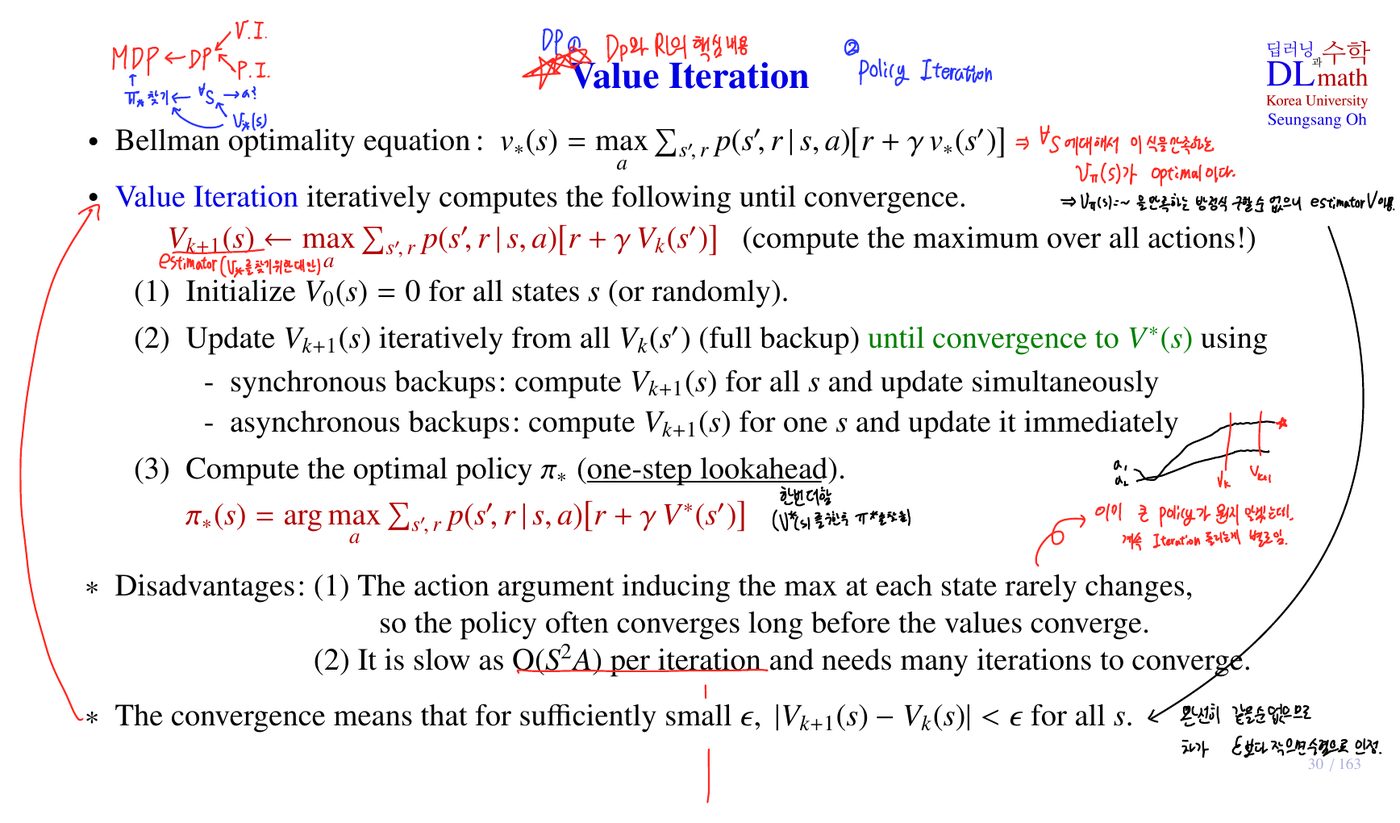
Bellman optimality equation은 \(v_*\)가 만족하는 방정식입니다. 그런데 \(v_*\)가 양변에 모두 있어서 바로 풀 수 없습니다. Value Iteration의 아이디어는 단순합니다. 아무 값 \(V_0\)에서 시작해서, 오른쪽에 현재 추정치 \(V_k\)를 넣어 계산한 값을 새 추정치 \(V_{k+1}\)로 삼습니다.
이것을 계속 반복하면 \(V_k\)는 \(V^*\)로 수렴합니다. 직관적으로는 \(V_k(s)\)가 “앞으로 \(k\)걸음만 최선을 다했을 때 얻는 보상”이라고 보면 됩니다. \(V_1\)은 한 걸음 보상만, \(V_2\)는 두 걸음까지 본 값이고, \(k\)가 커지면서 점점 먼 미래까지 반영됩니다(\(\gamma<1\)이면 먼 미래의 영향은 점점 작아져서 값이 수렴합니다).
세 단계
- 초기화: 모든 상태에서 \(V_0(s)=0\) (또는 임의의 값).
- 반복 업데이트: 모든 \(V_k(s')\)를 이용해 \(V_{k+1}(s)\)를 계산합니다(full backup). \(V^*\)로 수렴할 때까지 반복합니다. 업데이트 방식은 두 가지입니다.
- synchronous backup: 모든 \(s\)에 대해 \(V_{k+1}(s)\)를 먼저 다 계산한 뒤 한꺼번에 교체합니다. 배열이 두 개 필요합니다(old, new).
- asynchronous backup: 한 상태의 \(V_{k+1}(s)\)를 계산하자마자 바로 덮어씁니다. 같은 sweep 안에서 뒤에 계산하는 상태는 이미 갱신된 값을 씁니다. 배열이 하나면 되고 보통 더 빨리 수렴합니다.
- 정책 계산: \(V^*\)를 얻은 뒤 마지막에 한 번 one-step lookahead로 정책을 뽑습니다. \[\pi_*(s)=\arg\max_a\sum_{s',r}p(s',r|s,a)\big[r+\gamma V^*(s')\big]\] “한 걸음 앞을 내다보고, 그 결과가 가장 좋은 action을 고른다”는 뜻입니다. 이때도 \(p\)가 필요하다는 점을 기억하세요(→ 42쪽에서 RL이 \(Q\)를 쓰는 이유).
수렴 판정: 충분히 작은 \(\epsilon\)에 대해 모든 \(s\)에서 \(|V_{k+1}(s)-V_k(s)|<\epsilon\)이면 멈춥니다. 정확히 같아질 때까지 기다리면 끝나지 않을 수 있으므로 오차 허용치를 둡니다.
단점 두 가지 (시험 단골)
- 정책이 값보다 훨씬 먼저 수렴합니다. 각 상태에서 max를 만드는 action(argmax)은 거의 바뀌지 않습니다. 정책은 이미 최적인데 값의 소수점 자리를 맞추느라 계속 반복하는 셈입니다. 아래 robot car 위젯에서 직접 확인할 수 있습니다.
- 느립니다. 한 iteration에 \(O(S^2A)\)가 듭니다. 모든 상태 \(s\)(\(S\)개)에 대해, 모든 action \(a\)(\(A\)개)마다, 모든 다음 상태 \(s'\)(\(S\)개)를 더하기 때문입니다. 게다가 수렴까지 iteration도 많이 필요합니다.
Robot car로 직접 계산하기 p.31
로봇 자동차가 “멀리, 빨리” 달리고 싶어 합니다. 빨리 달리면 보상이 크지만 과열될 수 있습니다.
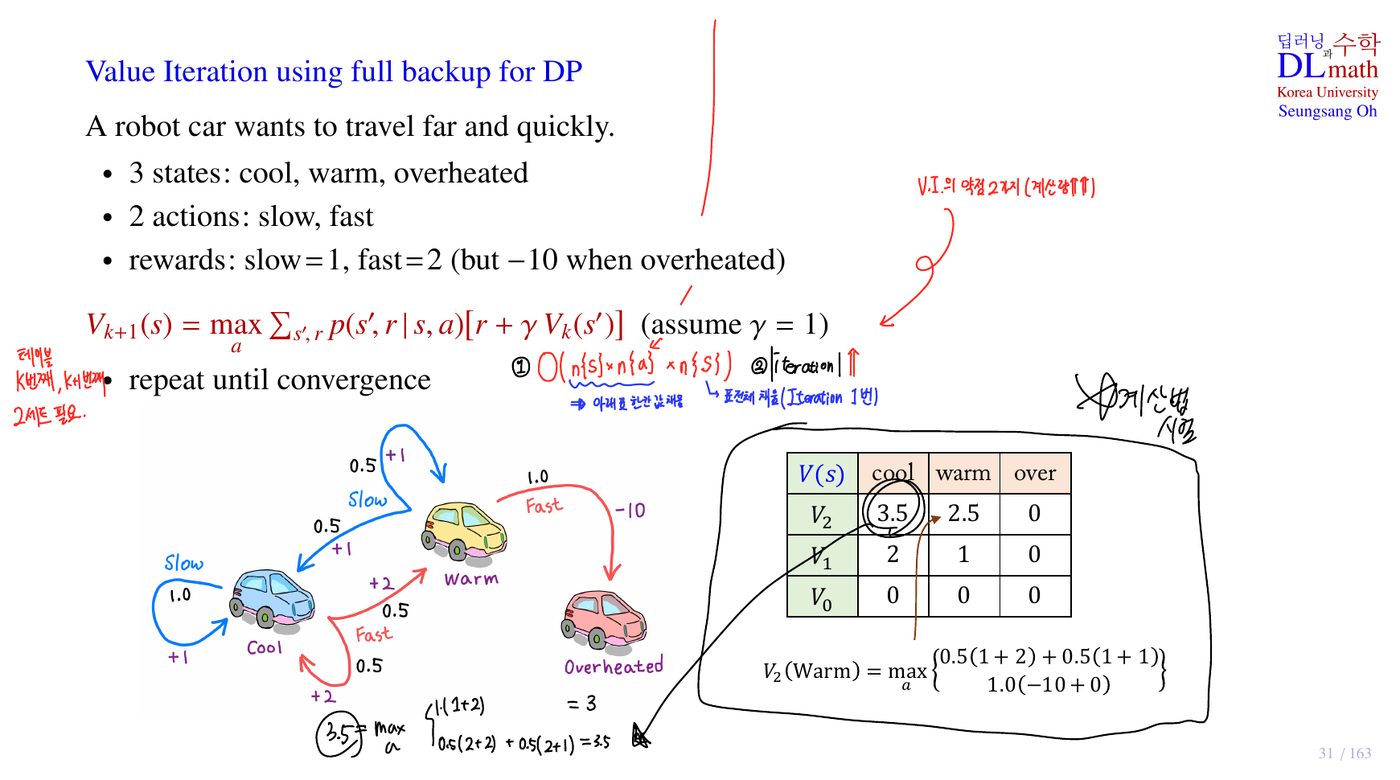
- 상태 3개: cool, warm, overheated(종료, 값 0)
- action 2개: slow, fast
- 보상: slow = +1, fast = +2, 단 과열되면 −10
- 전이: cool에서 slow → 확률 1.0으로 cool. cool에서 fast → 0.5 cool, 0.5 warm. warm에서 slow → 0.5 cool, 0.5 warm. warm에서 fast → 1.0으로 overheated(−10).
슬라이드처럼 \(\gamma=1\)로 두 번 계산하면 이렇습니다.
각 칸을 계산할 때 “action마다 기대값을 구하고(Σ), 그중 최댓값(max)을 고른다”는 두 단계를 반복합니다. 아래에서 한 단계씩 넘겨 보세요. \(\gamma\)를 0.9로 바꾸면 값이 수렴하는 것도 보입니다.
필기에 적어 둔 계산 비용: 한 iteration은 \(O(|S|\times|A|\times|S|)\)로 상태와 행동이 늘면 급격히 커지고, 이 반복을 여러 번 해야 합니다.
VI 알고리즘을 한 줄씩 p.32
배열 \(V\) 하나를 계속 덮어쓰므로 30쪽에서 말한 asynchronous(in-place) 방식입니다. 같은 sweep에서 뒤에 오는 상태는 이미 갱신된 앞 상태의 값을 쓰게 됩니다. \(\Delta\)는 “이번 바퀴에서 가장 많이 변한 상태의 변화량”이고, 이것조차 \(\epsilon\)보다 작으면 모든 상태가 충분히 안정되었다는 뜻입니다. 출력하는 정책 앞에 \(\approx\)가 붙는 이유는 \(V\)가 정확한 \(V^*\)가 아니라 오차 \(\epsilon\) 이내의 근사이기 때문입니다.
Grid world와 Q-table p.33
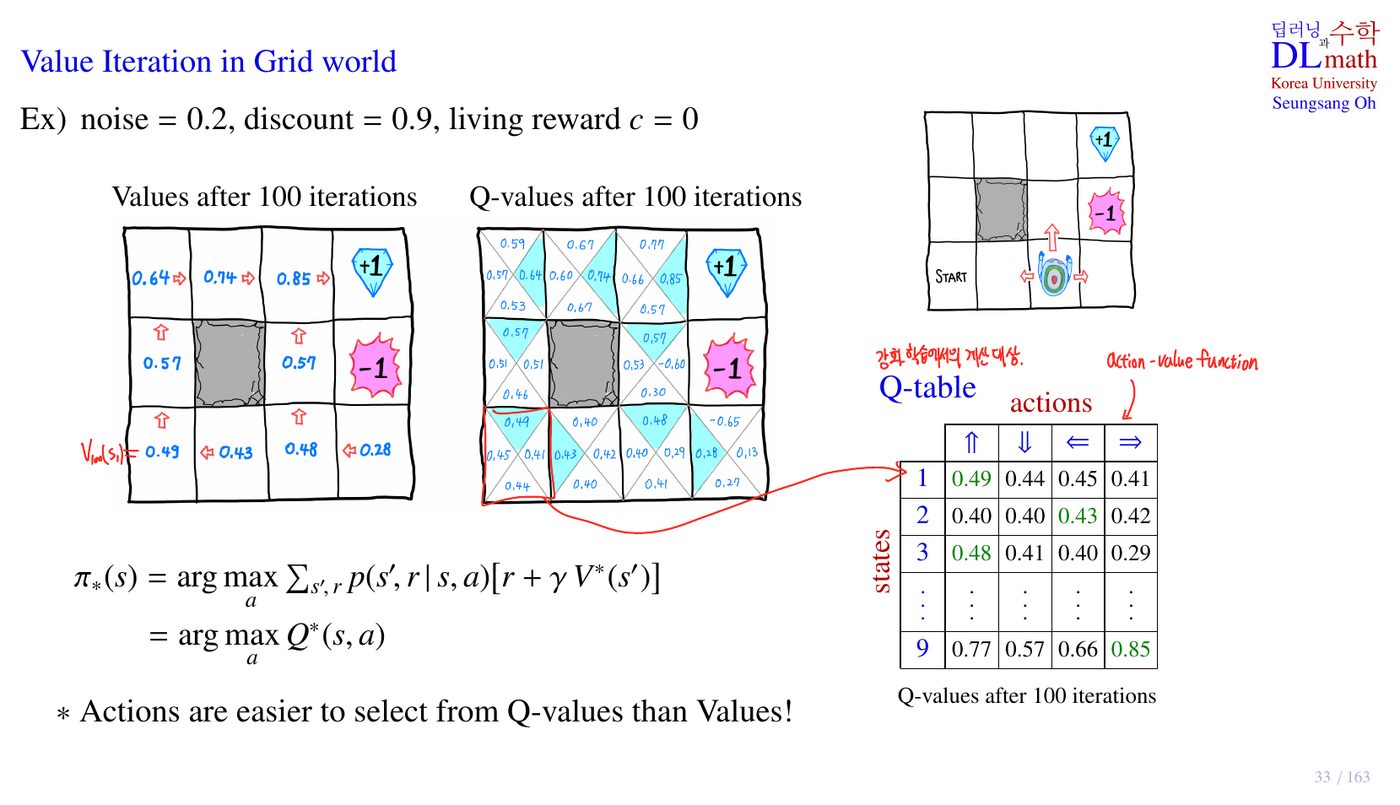
노이즈 0.2(의도한 방향 80%, 좌우 10%씩), \(\gamma=0.9\), living reward \(c=0\)인 grid world에서 100번 반복한 결과입니다. 왼쪽 그림은 상태마다 숫자 하나(\(V\)), 가운데 그림은 상태마다 숫자 네 개(\(Q\), 방향별)입니다.
예를 들어 START 위 칸(3,2)의 \(V\)는 0.57이고, 화살표(최적 action)는 ↑입니다. 그런데 \(V\) 그림만 보고 왜 ↑인지 알려면 “↑로 가면 80%로 위, 10%로 왼쪽, 10%로 오른쪽…”을 다시 계산해야 합니다. 즉 \(p\)가 필요합니다. 반면 \(Q\) 그림에는 각 방향의 값이 이미 적혀 있어서 가장 큰 숫자를 고르기만 하면 됩니다.
Q-table: 행은 상태(1~9), 열은 action(⇑⇓⇐⇒)인 표입니다. 강화학습에서 계산하고 갱신하는 대상이 바로 이 표입니다. 각 행에서 초록색으로 표시된 칸이 그 상태의 최댓값, 곧 최적 action입니다.
Policy Iteration p.34
Value Iteration이 “값을 완벽히 맞춘 뒤 정책을 고르는” 방식이라면, Policy Iteration은 “정책을 정하고 → 평가하고 → 고치는” 것을 반복합니다.
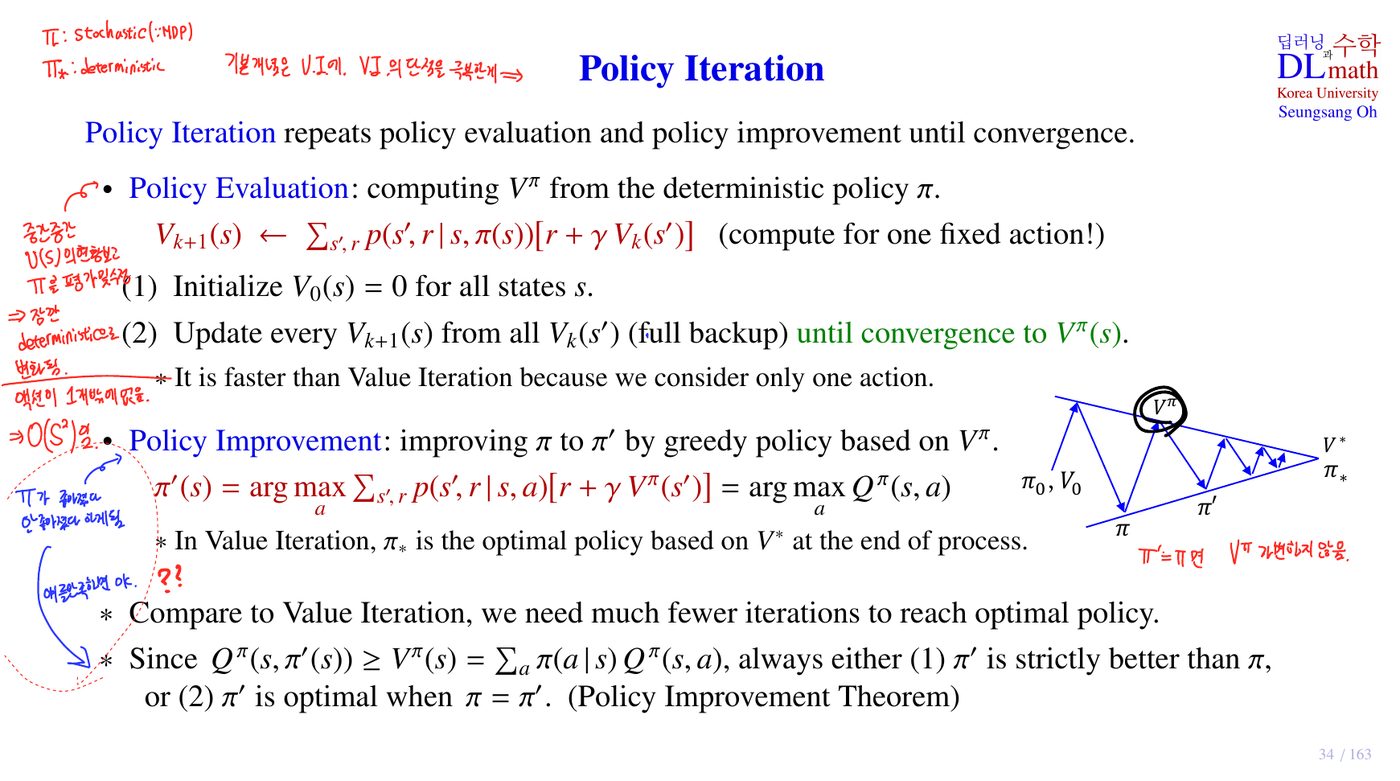
VI의 약점은 정책이 이미 정해졌는데도 값을 맞추느라 시간을 쓴다는 점이었습니다. 그렇다면 처음부터 정책을 주인공으로 두면 어떨까요? Policy Iteration은 두 단계를 번갈아 합니다.
① Policy Evaluation: 지금 정책이 얼마나 좋은가?
결정적(deterministic) 정책 \(\pi\)를 고정하고 \(V^\pi\)를 계산합니다.
VI 식과 비교하면 \(\max_a\)가 없고, action 자리에 \(\pi(s)\)가 들어갑니다. 즉 Bellman expectation equation을 반복해서 푸는 것입니다. action을 하나만 보므로 한 sweep이 \(O(S^2)\)로, VI보다 빠릅니다(“It is faster than Value Iteration because we consider only one action.”). \(V^\pi\)로 수렴할 때까지 반복합니다.
② Policy Improvement: 그 평가를 보고 정책을 고친다
평가된 \(V^\pi\)를 기준으로 각 상태에서 한 걸음 앞을 봤을 때 가장 좋은 action을 고릅니다. 이것을 greedy policy라고 하며, 이 과정을 greedification이라고도 부릅니다.
현재 업무 방식(\(\pi\))으로 한 분기를 운영해 성과를 측정합니다(evaluation). 측정 결과를 보고 “이 단계는 이렇게 바꾸면 더 낫겠다”는 부분을 고칩니다(improvement). 새 방식으로 다시 측정하고 고칩니다. 더 고칠 곳이 없으면 그 방식이 최선입니다.
VI와의 차이: VI에서 \(\pi_*\)는 과정 마지막에 \(V^*\)를 보고 한 번 뽑습니다. PI는 매 라운드 정책을 갱신하며, VI보다 훨씬 적은 iteration으로 최적 정책에 도달합니다.
왜 고친 정책이 항상 나아질까요? 핵심 부등식은 이것입니다.
최댓값은 어떤 평균보다도 크거나 같습니다. 그래서 (1) \(\pi'\)가 \(\pi\)보다 엄격히 좋거나, (2) \(\pi=\pi'\)이면 \(\pi'\)가 최적입니다. 이것이 다음 쪽의 Policy Improvement Theorem입니다.
Policy Improvement Theorem p.35
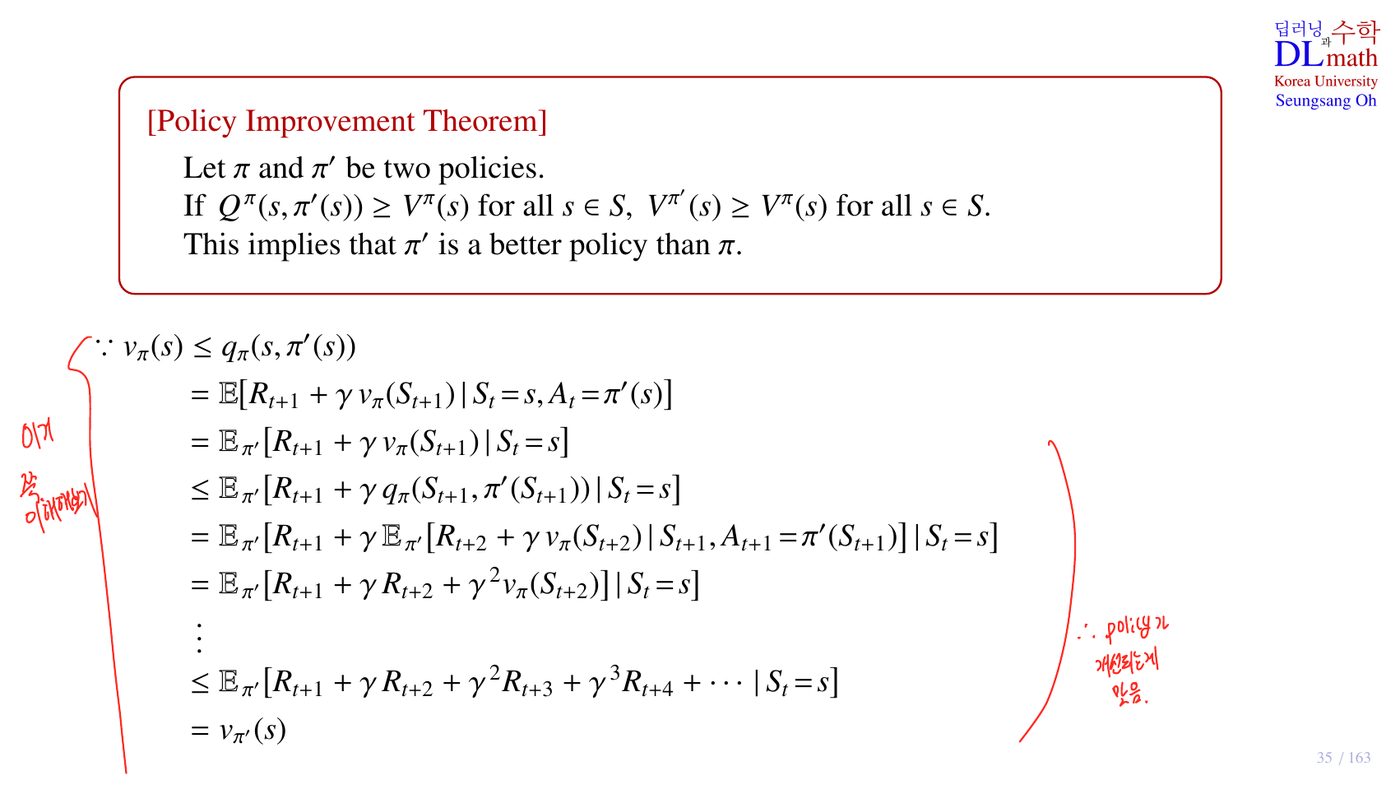
가정이 말하는 것: \(Q^\pi(s,\pi'(s))\)는 “지금 한 번만 \(\pi'\)의 action을 하고, 그 뒤로는 원래 정책 \(\pi\)를 따랐을 때의 가치”입니다. 가정은 “한 번만 바꿔도 손해가 없다”입니다.
결론이 말하는 것: \(V^{\pi'}(s)\)는 “지금부터 끝까지 계속 \(\pi'\)를 따랐을 때의 가치”입니다. 결론은 “계속 바꾸면 더 좋다”입니다.
평소 경로(\(\pi\))로 출근하다가, 첫 갈림길에서만 새 길(\(\pi'\))로 갔다가 다시 평소 경로로 돌아와도 손해가 없다고 해 봅시다. 그러면 두 번째 갈림길에서도, 세 번째에서도 같은 판단이 성립합니다. 모든 갈림길에서 새 길을 택하면 손해 없는 선택을 계속 쌓는 것이므로 전체도 손해가 없습니다. 증명은 이 말을 식으로 쓴 것입니다.
증명 따라가기
패턴은 “\(v_\pi\)가 보이면 \(\le q_\pi(\cdot,\pi'(\cdot))\)로 바꾸고, \(q_\pi\)를 한 걸음 펼친다”의 반복입니다. 한 번 반복할 때마다 \(\pi'\)를 따르는 구간이 한 걸음씩 늘어나고, 끝까지 가면 return 전체가 \(\pi'\)를 따르게 됩니다. 필기에 “이거 꼭 이해해서”라고 적어 둔 부분이므로 ①→②(펼치기)→④(가정 재사용)의 리듬을 기억하세요.
PI의 수렴과 알고리즘 p.36–37
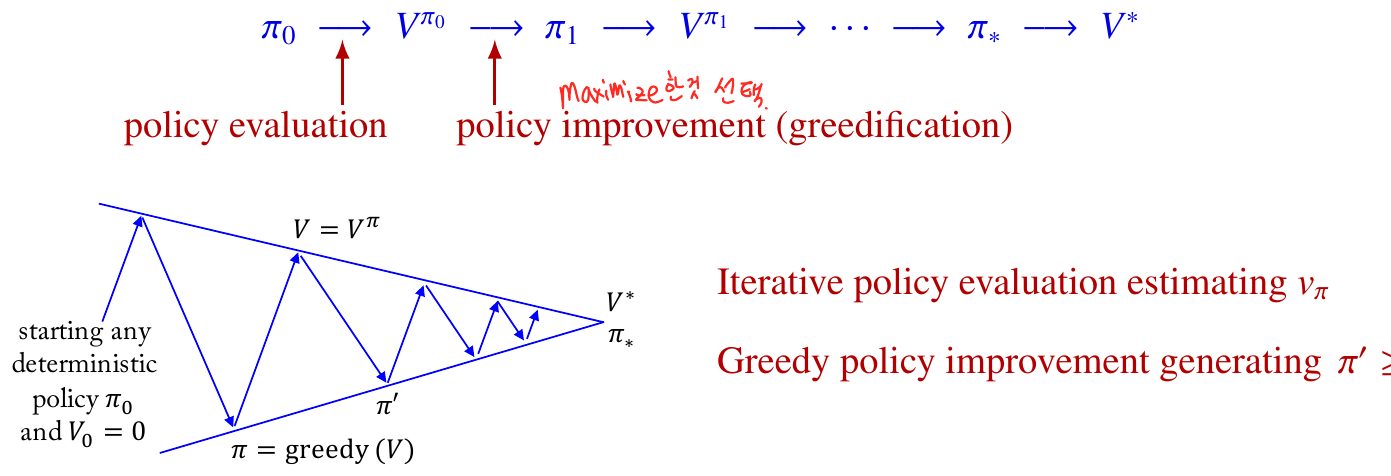
36쪽 그림의 지그재그는 이렇게 읽습니다. 위쪽 선은 “\(V=V^\pi\)” (값이 현재 정책과 일치), 아래쪽 선은 “\(\pi=\text{greedy}(V)\)” (정책이 현재 값에 대해 greedy). 평가는 위 선으로, 개선은 아래 선으로 끌어당깁니다. 한쪽을 맞추면 다른 쪽이 어긋나지만, 둘이 만나는 지점(\(V^*,\pi_*\))으로 점점 좁혀 갑니다.
- 유한 번 안에 끝납니다. 유한 MDP의 결정적 정책 개수는 \(|A|^{|S|}\)개로 유한합니다. 매 단계 정책이 엄격히 좋아지거나 멈추므로 같은 정책을 두 번 방문하지 않고, 결국 finite iterations 안에 최적에 도달합니다.
- 멈췄을 때 왜 최적인가? 새 greedy 정책 \(\pi'\)가 \(\pi\)보다 낫지 않고 같다면 \(v_\pi=v_{\pi'}\)이고, \[v_{\pi'}(s)=\max_a\sum_{s',r}p(s',r|s,a)\big[r+\gamma v_{\pi'}(s')\big]\] 이 성립합니다. 이것은 Bellman optimality equation 그 자체이므로 \(\pi'\)는 최적입니다.
알고리즘 (37쪽)
멈춤 조건이 “값의 변화”가 아니라 “정책의 변화”라는 점이 VI와 다릅니다. 아래 위젯은 robot car(γ = 0.9)에 일부러 나쁜 정책(cool → slow, warm → fast)을 주고 시작합니다.
정책 개선은 단 세 번이면 끝납니다. VI가 같은 답을 얻으려고 수십 번 반복했던 것과 비교해 보세요(평가 단계 안의 sweep은 따로 셉니다).
평가가 끝까지 수렴하지 않아도 된다 p.38
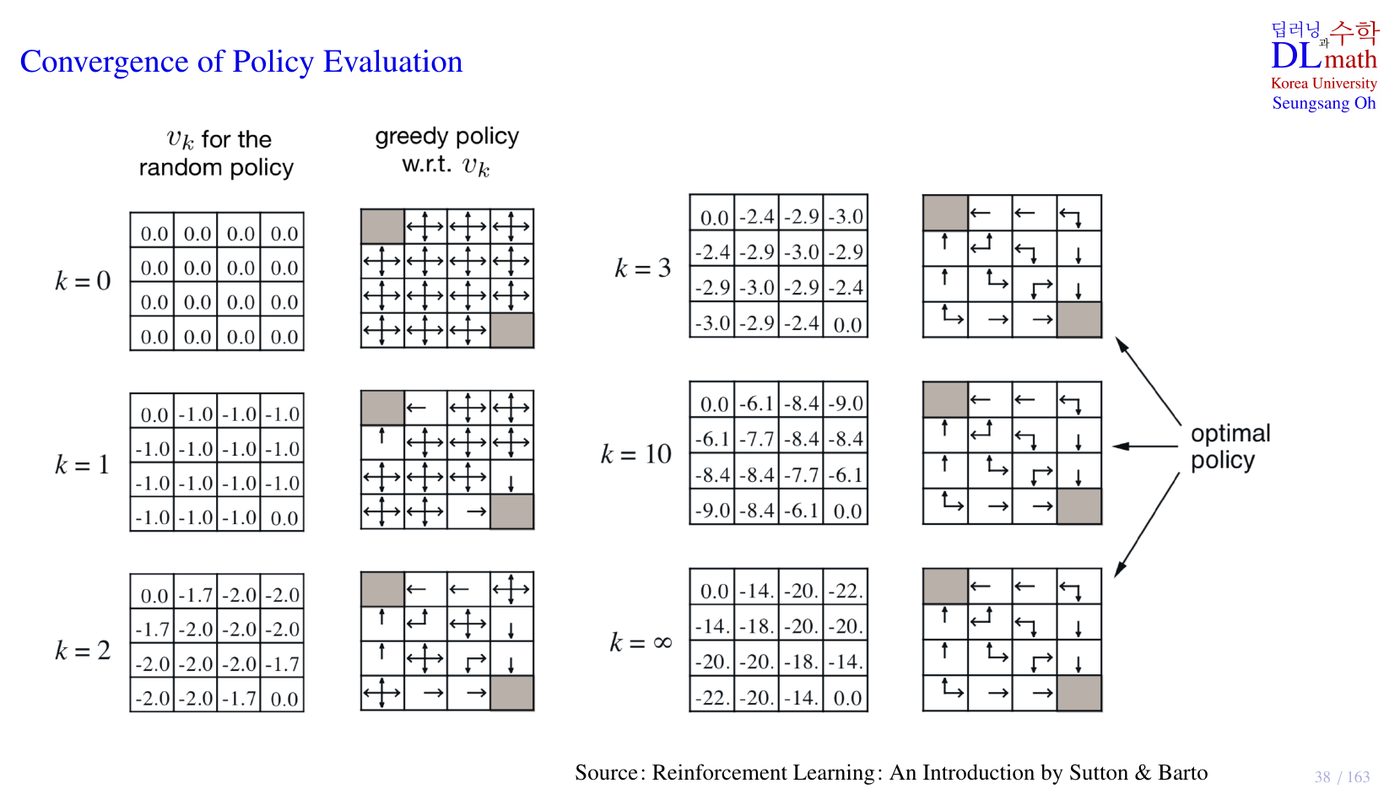
Sutton & Barto의 4×4 grid world 예제입니다. 회색 두 칸이 종료 상태이고, 한 번 움직일 때마다 보상 −1이므로 빨리 끝내는 것이 좋습니다. 정책은 상하좌우를 25%씩 고르는 random policy이고, 이 정책을 iterative policy evaluation으로 평가합니다.
| k | 무엇이 보이는가 |
|---|---|
| 0 | 모든 값 0. greedy 정책은 아무 방향이나 같음. |
| 1 | 종료 칸 외 모두 −1. 종료 칸 바로 옆에서만 “종료 쪽으로” 화살표가 생김. |
| 2 | 종료 근처가 −1.7, 먼 곳이 −2.0. 화살표가 조금 더 퍼짐. |
| 3 | 값은 −2.4 ~ −3.0으로 여전히 진짜 값과 다르지만, greedy 정책은 이미 최적. |
| 10, ∞ | 값은 계속 변해서 \(v_\pi\)(−14, −18, −20, −22)로 수렴하지만 정책은 k = 3과 같음. |
최적 정책을 얻는 데 정확한 \(v_\pi\)가 필요하지 않습니다. 대충 맞는 값으로도 greedy 정책은 올바르게 나옵니다. 그렇다면 evaluation을 매번 끝까지 수렴시킬 필요가 없습니다. 극단적으로 평가를 한 sweep만 하고 바로 개선하면 그것이 사실상 Value Iteration이고, 평가를 대충 하면서 개선과 섞어 쓰는 일반적인 틀이 43쪽의 GPI입니다.
DP가 요구하는 것, 그리고 한계 p.39
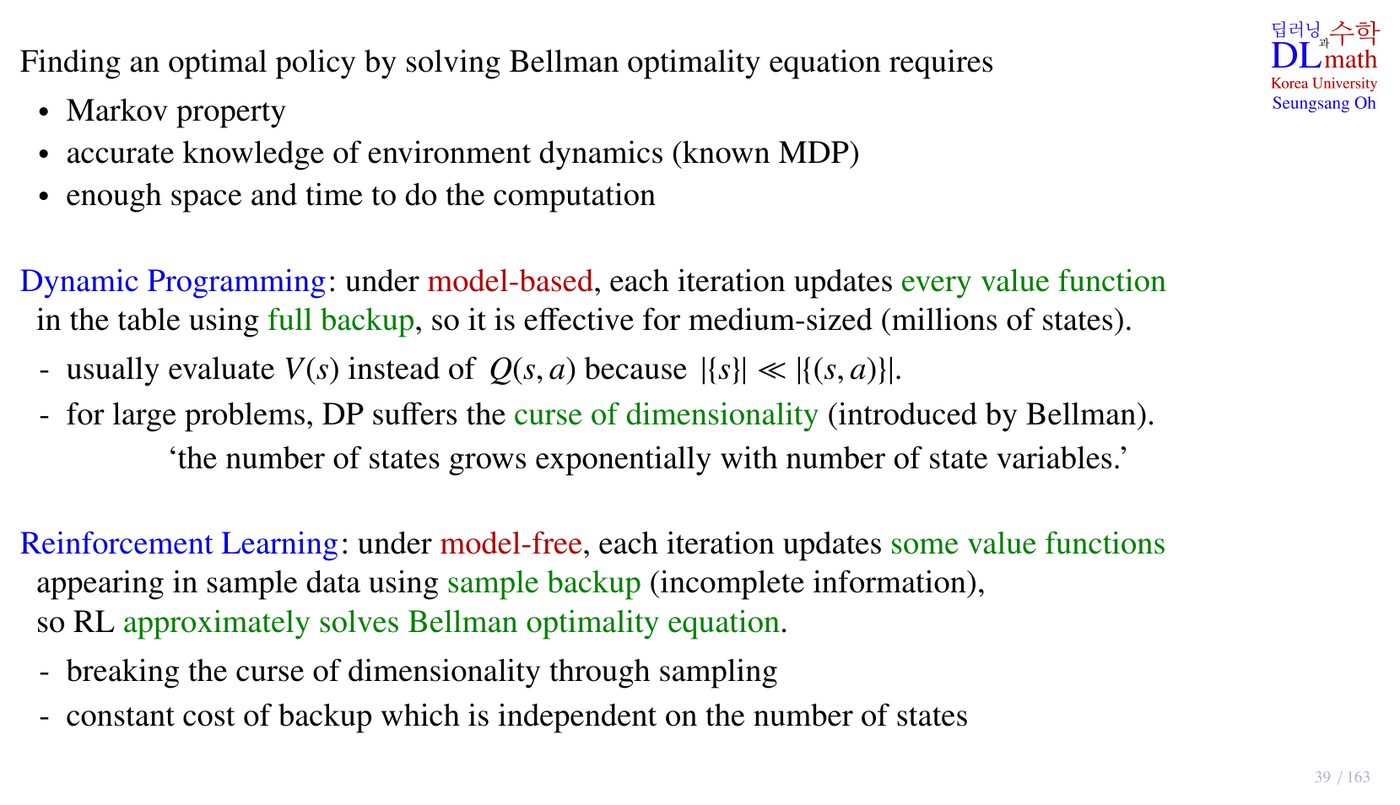
Bellman optimality equation을 풀어서 최적 정책을 찾으려면 세 가지가 필요합니다.
- Markov property: 다음 상태가 현재 상태와 행동에만 의존해야 재귀적 분해가 성립합니다.
- 환경 동역학에 대한 정확한 지식(known MDP): \(p(s',r|s,a)\)를 알아야 Σ를 계산할 수 있습니다.
- 계산할 충분한 공간과 시간: 모든 상태를 표에 저장하고 매번 전부 갱신해야 합니다.
Dynamic Programming
model-based에서 every value function을 full backup으로 갱신합니다. 중간 규모(수백만 상태)까지 효과적입니다. 보통 \(Q(s,a)\) 대신 \(V(s)\)를 평가합니다. \(|\{s\}|\ll|\{(s,a)\}|\)라서 표가 작기 때문입니다.
Reinforcement Learning
model-free에서 샘플에 등장한 some value functions만 sample backup으로 갱신합니다. 그래서 RL은 Bellman optimality equation을 approximately 풉니다.
Curse of dimensionality
Bellman이 이름 붙인 개념입니다. “상태 수가 상태 변수 개수에 대해 지수적으로 늘어난다.” 예를 들어 로봇의 상태가 위치, 속도, 각도 등 변수 10개로 표현되고 각 변수가 10단계라면 상태는 \(10^{10}\)개입니다. 변수 하나가 늘 때마다 10배가 됩니다. full backup은 이 모든 상태를 매번 갱신해야 하므로 감당이 안 됩니다.
바둑판은 \(19\times19=361\)개의 점이고, 각 점은 빈칸·흑·백 셋 중 하나입니다. 그래서 판의 모양은 최대 \(3^{19\times19}=3^{361}\approx10^{172}\)가지입니다(규칙상 실제로 나올 수 있는 국면만 세어도 약 \(2\times10^{170}\)개). 관측 가능한 우주의 원자가 약 \(10^{80}\)개이니, 상태 하나에 원자 하나씩 써서 표를 만들어도 턱없이 모자랍니다. 사실상 무한대입니다.
DP의 full backup은 iteration마다 이 모든 상태의 \(V(s)\)를 갱신해야 합니다. 표를 저장할 공간도, 한 바퀴를 돌 시간도 없으니 DP로는 시작조차 할 수 없습니다. 이 벽을 MC가 어떻게 넘는지는 44쪽에서 이어집니다.
RL은 이를 두 가지로 피합니다. ① sampling: 실제로 방문한 상태만 갱신합니다. ② backup 한 번의 비용이 상태 수와 무관하게 일정합니다(TD는 다음 상태 하나만 봅니다).
Part 4 · Reinforcement Learning
DP vs RL: 같은 Bellman 식, 다른 계산법 p.40–42
세 방법 모두 Bellman expectation equation \(v_\pi(s)=\mathbb E_\pi[G_t|S_t=s]=\mathbb E_\pi[R_{t+1}+\gamma v_\pi(S_{t+1})|S_t=s]\)에서 나옵니다. 차이는 기댓값 \(\mathbb E\)를 어떻게 다루는가입니다.
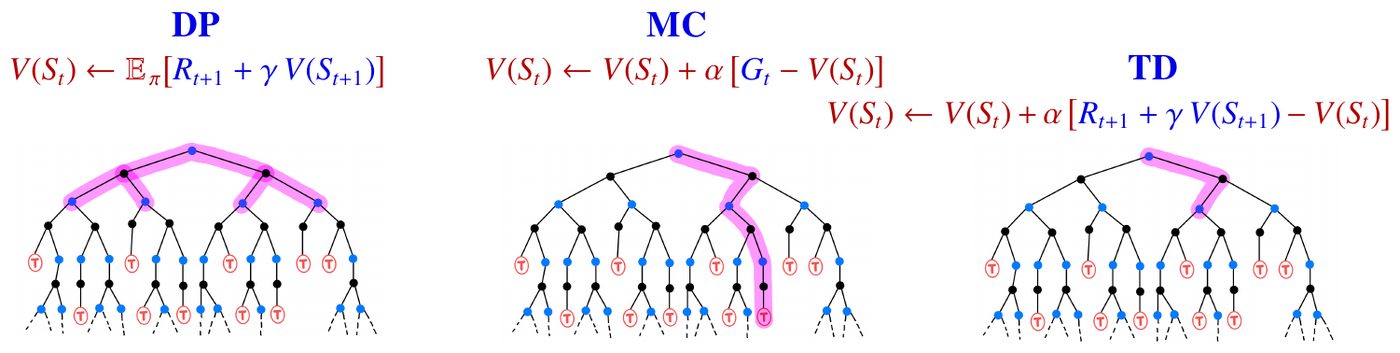
| 업데이트 | 무엇을 쓰나 | 모양 | |
|---|---|---|---|
| DP | \(V(S_t)\leftarrow\mathbb E_\pi[R_{t+1}+\gamma V(S_{t+1})]\) | \(p\)로 정확한 기댓값 계산 + 다음 상태 추정치 | 넓고 얕음 (모든 가지, 한 단계) |
| MC | \(V(S_t)\leftarrow V(S_t)+\alpha[G_t-V(S_t)]\) | 에피소드 끝까지 실제로 받은 return \(G_t\) | 좁고 깊음 (한 가지, 끝까지) |
| TD | \(V(S_t)\leftarrow V(S_t)+\alpha[R_{t+1}+\gamma V(S_{t+1})-V(S_t)]\) | 실제 한 걸음 보상 + 다음 상태 추정치 | 좁고 얕음 (한 가지, 한 단계) |
MC는 Bellman 식의 왼쪽 표현 \(\mathbb E[G_t]\)를, TD는 오른쪽 표현 \(\mathbb E[R_{t+1}+\gamma v(S_{t+1})]\)을 샘플 하나로 대신합니다. \(\alpha[\text{target}-V]\) 꼴은 “목표값 쪽으로 \(\alpha\)만큼 다가간다”는 뜻입니다.
왜 DP는 V를, RL은 Q를 평가하나 (42쪽)
DP와 RL은 모두 tabular updating methods입니다. value function의 표를 만들고, Bellman 식으로 반복 갱신해서 최적 정책을 찾습니다. 그런데 정책을 개선(greedy)하는 단계에서 차이가 납니다.
- DP: \(V\)만 있어도 됩니다. 모델을 알므로 \(\pi'(s)=\arg\max_a\sum_{s',r}p(s',r|s,a)[r+\gamma V^\pi(s')]\)를 계산할 수 있습니다. 그리고 \(V\) 표가 \(Q\) 표보다 작습니다.
- RL: 위 식의 \(p\)를 모릅니다. \(V\)만으로는 “어느 action이 어느 상태로 데려가는지” 모르므로 정책을 고를 수 없습니다. 그래서 \(Q(s,a)\)를 직접 평가하고 \(\pi'(s)=\arg\max_aQ^\pi(s,a)\)로 고릅니다. 이 식에는 \(p\)가 없으므로 model-free에서도 작동합니다.
작은 예로 보기: V 표만 있으면 왜 막히나
상태 \(s\)에서 할 수 있는 action이 left, right 두 개라고 합시다. 지금까지의 경험으로 표를 하나 만들어 두었습니다.
V 표만 가진 경우
\(V(s_1)=10,\ V(s_2)=0\). \(s_1\)이 좋은 상태라는 건 압니다.
그런데 left를 하면 \(s_1\)로 가나요, \(s_2\)로 가나요? 몇 % 확률로요? 그 답이 바로 전이 확률 \(p(s'|s,a)\)인데, unknown MDP에서는 이것을 모릅니다. 그래서 \(\arg\max_a\sum_{s'}p(s'|s,a)[r+\gamma V(s')]\)를 계산할 수 없고, 어떤 action을 골라야 할지 정할 방법이 없습니다.
Q 표를 가진 경우
\(Q(s,\text{left})=7.2,\ Q(s,\text{right})=1.5\).
\(Q(s,a)\)는 “이 상태에서 이 action을 했을 때의 기대 return”이고, 어디로 몇 % 확률로 가는지가 샘플을 통해 이미 값 안에 녹아 있습니다. 그래서 \(p\)를 몰라도 가장 큰 Q값의 action(left)을 바로 고를 수 있습니다: \(\pi'(s)=\arg\max_aQ(s,a)\).
Q 표는 \(|S|\times|A|\)칸이라 V 표보다 크지만, model-free에서 정책을 개선할 수 있는 형태는 이것뿐입니다. 그래서 강화학습에서는 필연적으로 Q함수를 학습합니다. 23쪽에서 본 비대칭과 같은 이야기입니다. \(v_*(s)=\max_aq_*(s,a)\)이므로 Q에서 V는 바로 얻지만, V에서 Q를 얻으려면 \(p\)가 필요합니다.
Generalized Policy Iteration (GPI) p.43
평가(PE)와 개선(PI)을 번갈아 하되, 각각을 끝까지 하지 않아도 된다.
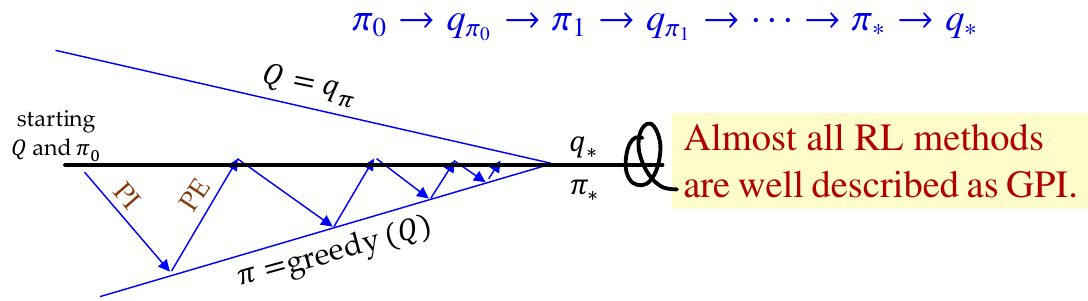
- Policy Iteration은 서로 상호작용하는 두 과정입니다. Policy Evaluation은 value function을 “현재 정책과 일관되게” 만들고, Policy Improvement는 정책을 “현재 value function에 대해 greedy하게” 만듭니다.
- PI에서는 한쪽이 완전히 끝난 뒤(completes) 다른 쪽을 시작합니다(full backup). 38쪽에서 봤듯이 그럴 필요는 없습니다.
- GPI는 현재 정책의 진짜 값에 근사(approximated)한 value function을 쓰고(sample backup), 정책도 반복적으로 개선해서 최적에 다가갑니다.
- PE와 PI가 모두 안정되면(더 이상 바뀌지 않으면) Bellman optimality equation이 성립하므로 값과 정책은 optimal입니다.
RL에서는 \(V\) 대신 \(Q\)를 씁니다(42쪽 이유). 그림의 위쪽 선이 \(Q=q_\pi\), 아래쪽 선이 \(\pi=\text{greedy}(Q)\)입니다. 화살표가 선에 끝까지 닿지 않는 것은 각 단계를 대충만 한다는 뜻입니다.
Monte Carlo method p.44
끝까지 해 보고, 결과를 평균 낸다.
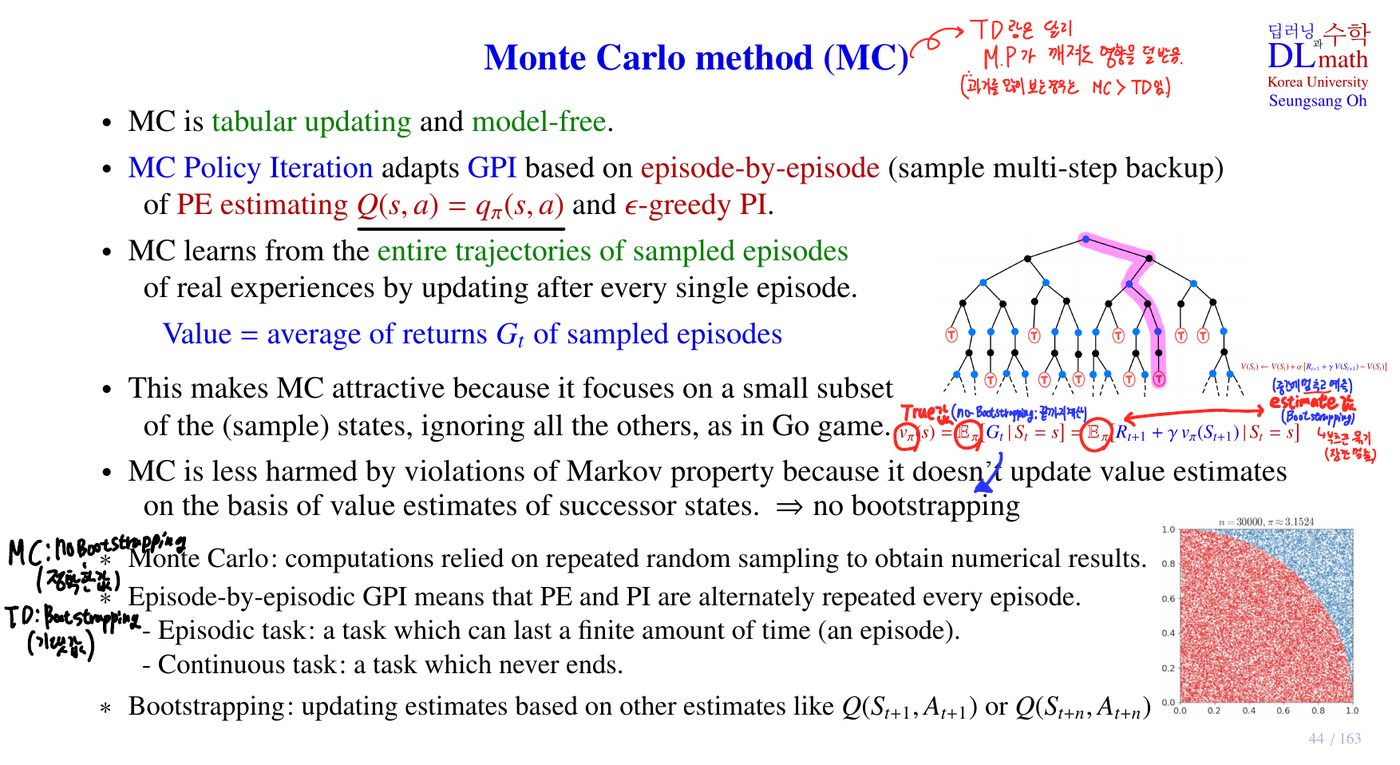
Monte Carlo라는 이름은 카지노 도시에서 왔습니다. 반복적인 무작위 샘플링으로 수치를 얻는 계산법을 통칭합니다. 슬라이드 오른쪽 아래 그림이 대표 예입니다. 정사각형 안에 점을 무작위로 뿌리고 사분원 안에 들어간 비율에 4를 곱하면 π에 가까워집니다. 큰 수의 법칙 덕분에 점이 많을수록 정확해집니다.
강화학습의 MC
- MC는 tabular updating이고 model-free입니다.
- MC Policy Iteration은 episode-by-episode(sample multi-step backup)로 GPI를 합니다. PE는 \(Q(s,a)=q_\pi(s,a)\)를 추정하고, PI는 \(\epsilon\)-greedy로 개선합니다.
- MC는 샘플 에피소드의 전체 궤적(entire trajectories)에서 배우며, 에피소드가 하나 끝날 때마다 갱신합니다. Value = average of returns \(G_t\) of sampled episodes.
- 실제 방문한 일부 상태에만 집중하고 나머지는 무시합니다(“focuses on a small subset of the (sample) states, ignoring all the others, as in Go game”). 아래 상자에서 자세히 봅니다.
- MC는 Markov property가 깨져도 피해가 적습니다. 다음 상태의 추정치를 이용해 갱신하지 않기 때문입니다(no bootstrapping). 실제로 받은 보상 합만 씁니다.
\(10^{172}\)개의 국면 가운데 실제 대국에 나오는 것은 극히 일부입니다. 첫 수는 대부분 화점이나 소목 근처에 두고, 판 전체가 흑돌로 덮인 모양 같은 것은 실제로 나오지 않습니다. MC는 실제로 한 판을 끝까지 두고(에피소드 하나), 그 판에서 방문한 국면(샘플)들의 값만 그 판의 결과(이겼나 졌나 = return)로 갱신합니다.
- 갱신 비용이 “전체 상태 수 \(10^{172}\)”가 아니라 “이번 판의 길이(수백 수)”에 비례합니다.
- 실제 대국에 자주 나오는 중요한 국면일수록 자주 방문되어 정확해지고, 나오지 않는 국면은 계산하지 않습니다. 계산을 쓸모 있는 곳에만 씁니다.
- 그래서 상태 공간이 천문학적이어도 차원의 저주를 피할 수 있습니다. “실제로 끝까지 둬 보고 결과로 평가한다”는 이 생각은 AlphaGo의 Monte Carlo Tree Search로 이어집니다.
“다른 추정치를 이용해 추정치를 갱신하는 것.” 예: \(Q(S_t,A_t)\)를 갱신할 때 \(Q(S_{t+1},A_{t+1})\)이라는 또 다른 추정치를 쓰는 것. 신발 끈(bootstrap)을 잡아당겨 자기 몸을 들어 올린다는 표현에서 왔습니다. 필기 정리: MC는 no bootstrapping(실제 값, 정답 기반), TD는 bootstrapping(추정치 기반).
- Episode-by-episodic GPI: 에피소드마다 PE와 PI를 번갈아 합니다.
- Episodic task: 유한한 시간 안에 끝나는 과제(게임 한 판). Continuing task: 끝나지 않는 과제(온도 조절기). MC는 \(G_t\)를 얻으려면 끝이 있어야 하므로 episodic task에서만 쓸 수 있습니다.
MC Prediction (Policy Evaluation) p.45
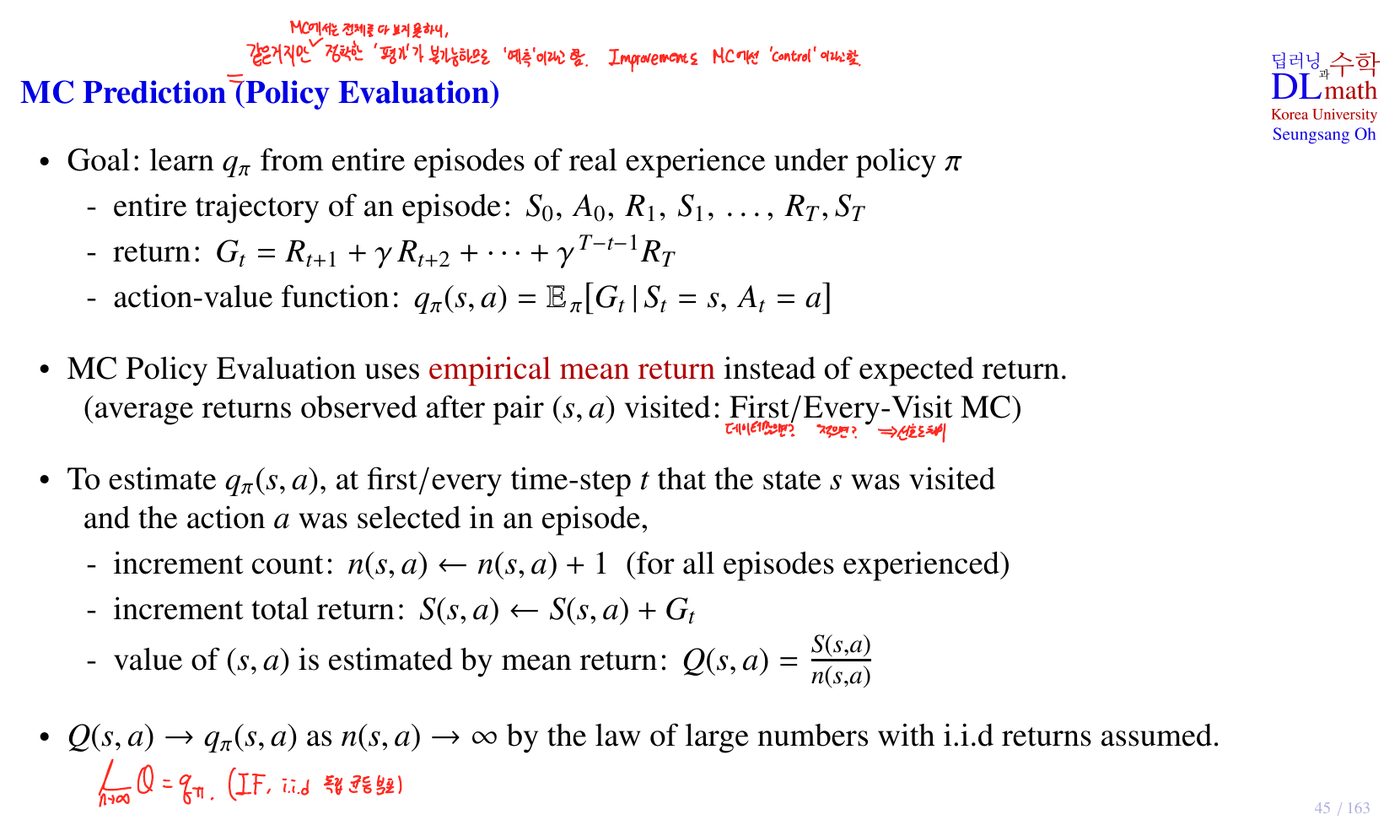
목표: 정책 \(\pi\)를 따라 실제로 겪은 에피소드 전체로부터 \(q_\pi\)를 배운다.
- 에피소드 궤적: \(S_0,A_0,R_1,S_1,\dots,R_T,S_T\)
- return: \(G_t=R_{t+1}+\gamma R_{t+2}+\cdots+\gamma^{T-t-1}R_T\) (유한 합)
- action-value: \(q_\pi(s,a)=\mathbb E_\pi[G_t|S_t=s,A_t=a]\)
MC policy evaluation은 기댓값(expected return)을 계산하는 대신 경험적 평균(empirical mean return)을 씁니다. 모델이 없으니 기댓값을 계산할 방법이 없고, 대신 실제로 관찰한 값을 평균 냅니다.
First-visit vs Every-visit
한 에피소드 안에서 같은 \((s,a)\)가 여러 번 나올 수 있습니다. 예: \((s_1,a_1)\)이 t = 2와 t = 7에 나왔다면
- First-visit MC: 첫 방문(t = 2)의 \(G_2\)만 평균에 넣습니다.
- Every-visit MC: 두 번 모두(\(G_2\)와 \(G_7\)) 넣습니다.
둘 다 방문이 무한히 많아지면 \(q_\pi\)로 수렴합니다.
추정 절차
first/every 방문 시점 \(t\)에 \(s\)를 방문하고 \(a\)를 선택했다면(경험한 모든 에피소드에 대해)
방문 횟수 \(n\)과 return의 총합 \(S\)를 기록하고, 평균을 \(Q\)로 씁니다. 큰 수의 법칙에 따라 return이 i.i.d.라고 가정하면 \(n(s,a)\to\infty\)일 때 \(Q(s,a)\to q_\pi(s,a)\)입니다(19쪽 Law of large numbers와 연결).
새로 생긴 식당의 “평균 만족도”를 알고 싶은데 메뉴판도 후기도 없다면, 갈 때마다 만족도를 적어 두고 평균을 내면 됩니다. 방문이 쌓일수록 평균은 진짜 값에 가까워집니다.
Incremental mean과 constant-α p.46
평균을 구하려고 지금까지의 모든 return을 저장할 필요가 없다.
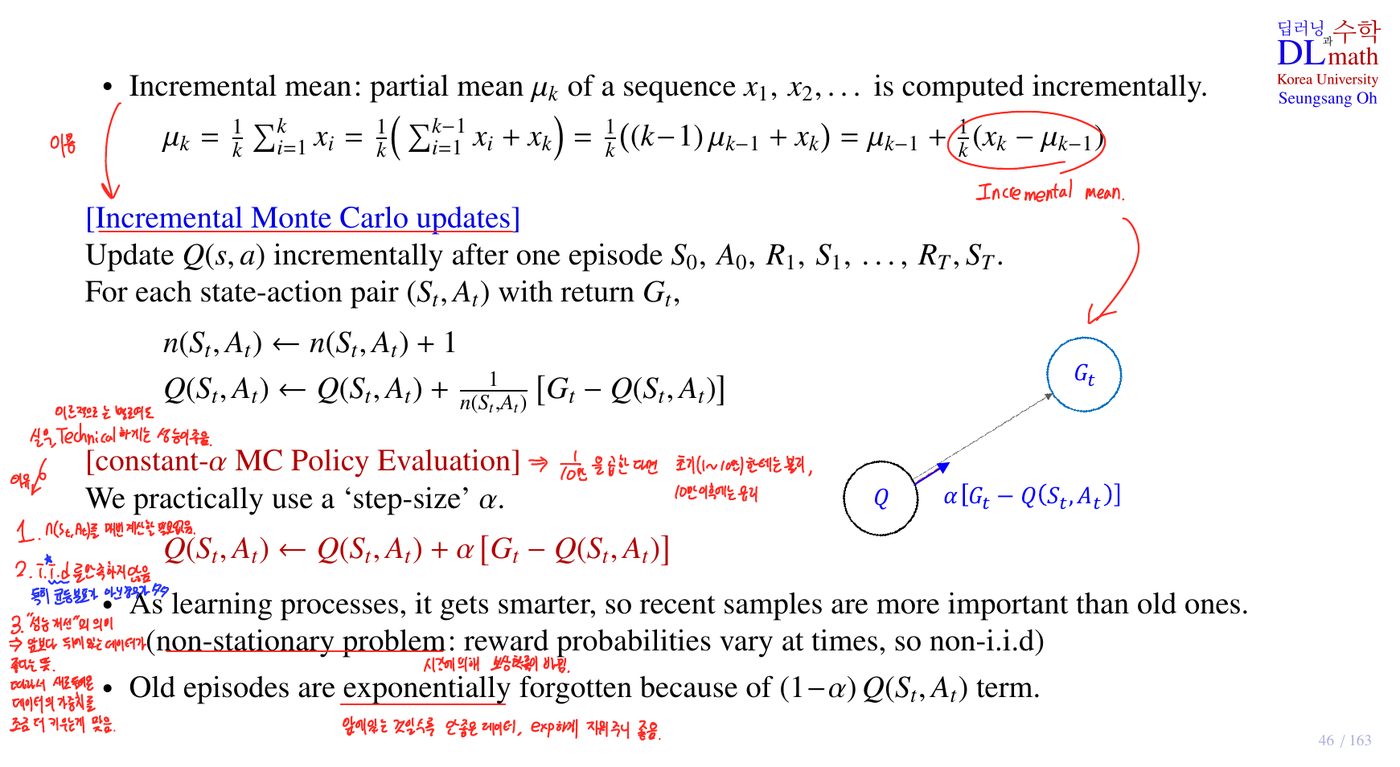
Incremental mean
“새 평균 = 옛 평균 + (1/k) × (새 값 − 옛 평균)”. 옛 평균과 개수만 기억하면 됩니다. 괄호 안 \(x_k-\mu_{k-1}\)은 “예상과 실제의 차이(오차)”이고, 그 오차의 \(1/k\)만큼 평균을 고칩니다. 이 “추정치 ← 추정치 + 보폭 × (목표 − 추정치)” 형태가 이후 MC, Sarsa, Q-learning 업데이트의 공통 뼈대입니다.
Incremental MC update
Constant-α MC Policy Evaluation
실제로는 \(1/n\) 대신 고정된 step-size \(\alpha\)를 씁니다. 이유는 다음과 같습니다.
- 학습이 진행될수록 에이전트(정책)가 똑똑해지므로 최근 샘플이 옛 샘플보다 더 중요합니다. 초반의 엉터리 정책으로 얻은 return을 지금과 같은 무게로 평균 내면 안 됩니다.
- 이것이 non-stationary problem입니다. 보상 확률이 시간에 따라 변하므로 샘플은 i.i.d.가 아닙니다. 45쪽의 큰 수의 법칙 가정이 깨집니다.
- 옛 에피소드는 \((1-\alpha)Q(S_t,A_t)\) 항 때문에 지수적으로 잊혀집니다. 식을 펼치면 \[Q_k=(1-\alpha)^kQ_0+\sum_{i=1}^k\alpha(1-\alpha)^{k-i}G_i\] \(i\)번째 return의 가중치 \(\alpha(1-\alpha)^{k-i}\)는 오래된 것일수록 지수적으로 작아집니다(exponential recency-weighted average). 반면 \(1/n\)은 모든 return에 같은 가중치 \(1/k\)를 줍니다.
Exploitation vs Exploration p.47
아는 맛집에 갈까, 새 식당에 가 볼까?
온라인 의사결정에는 근본적인 선택이 있습니다.
- Exploitation (활용): 이미 아는 정보로 최선의 결정을 합니다. 새 에피소드를 샘플링할 때 Q값이 가장 높은 action을 고르면, 이미 유망한 영역 안에서 정책을 효율적으로 다듬을 수 있습니다.
- Exploration (탐험): 정보를 더 모으려고 새로운 결정을 시도합니다. \(\epsilon\) 확률로 무작위 action을 하나 더 고르면, 상태-행동 공간에서 새롭고 어쩌면 더 유망한 영역을 찾을 수 있습니다.
점심마다 지금까지 가장 맛있었던 식당만 가면(순수 exploitation) 그 식당보다 맛있는 곳이 바로 옆에 있어도 영영 모릅니다. 매일 새 식당만 가면(순수 exploration) 맛있는 곳을 알아도 활용하지 못합니다. model-free에서는 이 문제가 특히 심각합니다. 한 번도 해 보지 않은 action의 \(Q\)는 영원히 초기값 그대로라서, greedy만 하면 더 좋은 action을 발견할 기회가 없습니다.
- 둘 사이의 균형을 위해 \(\epsilon\)-greedy policy를 씁니다.
- 최선의 장기 전략에는 단기적 희생이 포함될 수 있으므로, 전체적으로 최선의 결정을 하려면 충분한 정보를 모아야 합니다.
action이 두 개 있고, 진짜 평균 보상은 \(a_1=+1\), \(a_2=+5\)라고 합시다(에이전트는 이 값을 모릅니다). 처음에 한 번씩 해 봤는데, 보상에는 잡음이 있어서 \(a_2\)가 운 나쁘게 \(-2\)가 나왔습니다. 그러면 \(Q(a_1)=1,\ Q(a_2)=-2\)입니다.
- greedy만 하면 앞으로 영원히 \(a_1\)만 고릅니다. \(a_2\)는 다시 시도되지 않으니 \(Q(a_2)=-2\)라는 잘못된 추정이 고쳐질 기회도 없습니다. 매 step 기대 보상 4씩, 1,000번이면 4,000을 손해 봅니다.
- 문제의 뿌리는 경험하지 않은 action에 대해서는 데이터가 없다는 것입니다. model-free에서는 action의 결과를 알아낼 방법이 직접 해 보는 것(샘플)뿐입니다. 지금 가장 좋아 보이는 action만 고집하면, 아직 데이터가 부족한 action 가운데 훨씬 좋은 것이 있을 가능성을 통째로 무시하게 됩니다.
- ε-greedy는 모든 action에 0이 아닌 확률을 주는 stochastic policy입니다. 가끔 손해(실패)를 보더라도 \(a_2\)를 계속 시도하게 되고, \(Q(a_2)\)가 진짜 값 5 근처로 올라가면 결국 \(a_2\)가 greedy action이 됩니다. 탐험 비용보다 얻는 이득이 훨씬 큽니다.
MC Control: ε-greedy Policy Improvement p.48
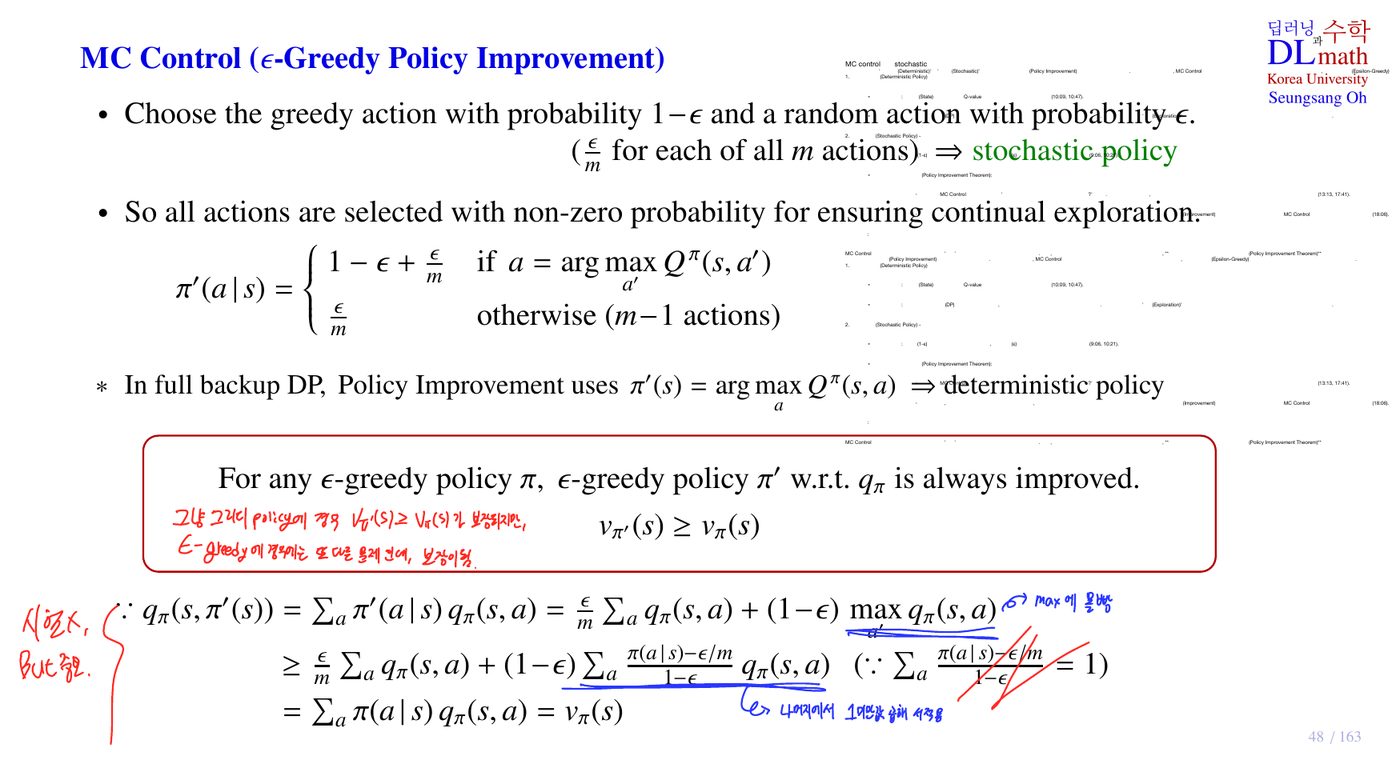
확률 \(1-\epsilon\)으로 greedy action을, 확률 \(\epsilon\)으로 무작위 action을 고릅니다. 무작위로 고를 때 \(m\)개 action 각각은 \(\epsilon/m\)의 확률을 가지며, 그 안에 greedy action도 포함됩니다. 그래서
모든 action이 0이 아닌 확률로 선택되므로 탐험이 계속 보장됩니다. 결과는 stochastic policy입니다. 반면 full backup DP의 policy improvement \(\pi'(s)=\arg\max_aQ^\pi(s,a)\)는 deterministic policy입니다. DP는 모든 상태·행동을 계산하므로 탐험할 필요가 없습니다.
증명 읽기
- 첫 줄: \(\pi'\)의 확률(모든 action에 \(\epsilon/m\), greedy에 \(1-\epsilon\) 추가)을 그대로 대입했습니다.
- 부등호: 가중치 \(w_a=\frac{\pi(a|s)-\epsilon/m}{1-\epsilon}\)는 0 이상이고(\(\pi\)도 ε-greedy라 \(\pi(a|s)\ge\epsilon/m\)) 합이 1입니다(\(\sum_a\pi(a|s)=1\), \(\sum_a\epsilon/m=\epsilon\)이므로 \(\frac{1-\epsilon}{1-\epsilon}=1\)). 따라서 \(\sum_aw_aq_\pi(s,a)\)는 \(q_\pi\)의 가중평균이고, 최댓값은 어떤 가중평균보다도 크거나 같습니다.
- 마지막 줄: 정리하면 \(\frac{\epsilon}{m}\)항이 상쇄되고 \(\sum_a\pi(a|s)q_\pi(s,a)=v_\pi(s)\)가 남습니다.
- 따라서 \(q_\pi(s,\pi'(s))\ge v_\pi(s)\)이고, Policy Improvement Theorem(35쪽)에 의해 \(v_{\pi'}\ge v_\pi\)입니다.
필기 메모처럼, 그냥 greedy policy일 때는 \(v_{\pi'}\ge v_\pi\)가 보장되었는데 ε-greedy일 때도 같은 방식으로 보장된다는 것을 보인 것입니다.
GLIE: 탐험은 무한히, 결국엔 greedy로 p.49
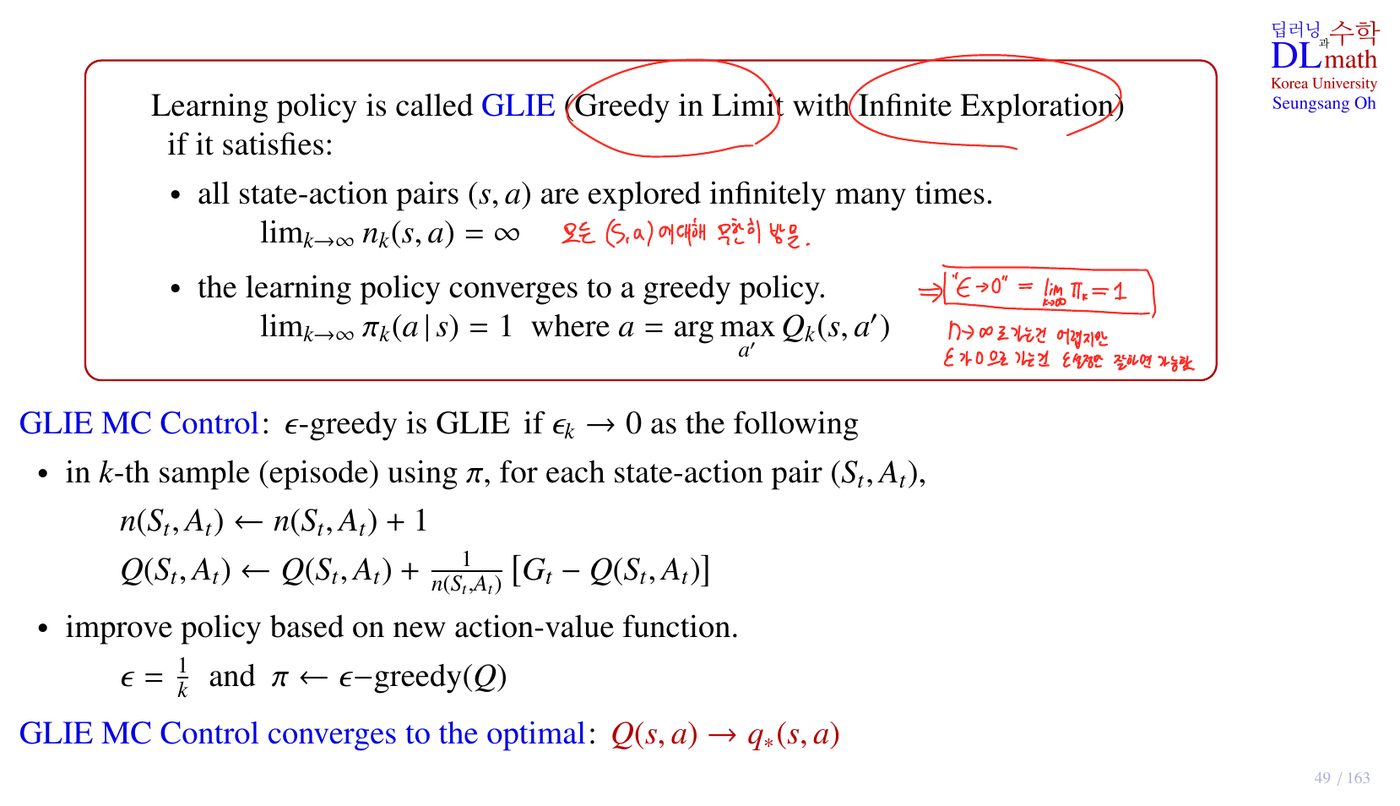
ε-greedy에는 문제가 있습니다. \(\epsilon\)이 고정되어 있으면 정책은 영원히 \(\epsilon\)만큼 엉뚱한 행동을 하므로 진짜 최적(결정적 greedy) 정책이 되지 못합니다. 반대로 \(\epsilon\)을 너무 빨리 0으로 만들면 탐험이 부족합니다. 그래서 두 조건을 동시에 요구합니다.
- Infinite Exploration: 모든 상태-행동 쌍을 무한히 많이 탐험한다. \(\lim_{k\to\infty}n_k(s,a)=\infty\)
- Greedy in the Limit: 학습 정책이 greedy 정책으로 수렴한다. \(\lim_{k\to\infty}\pi_k(a|s)=1\), 단 \(a=\arg\max_{a'}Q_k(s,a')\)
필기 메모: “\(\epsilon\to0\)” 이 곧 \(\lim\pi_k=1\)입니다. \(n\to\infty\)로 가는 건 어렵지 않지만, \(\epsilon\)이 0으로 가는 건 조절해야 합니다. 적당한 속도가 \(\epsilon_k=1/k\)입니다. \(\sum 1/k=\infty\)이므로 탐험 기회는 무한히 많이 남고, 동시에 \(1/k\to0\)이므로 결국 greedy가 됩니다.
GLIE MC Control
\(k\)번째 에피소드에서 \(\pi\)를 따라 얻은 각 \((S_t,A_t)\)에 대해
그러면 GLIE MC Control은 최적으로 수렴합니다: \(Q(s,a)\to q_*(s,a)\).
Monte Carlo 알고리즘 전체 p.50
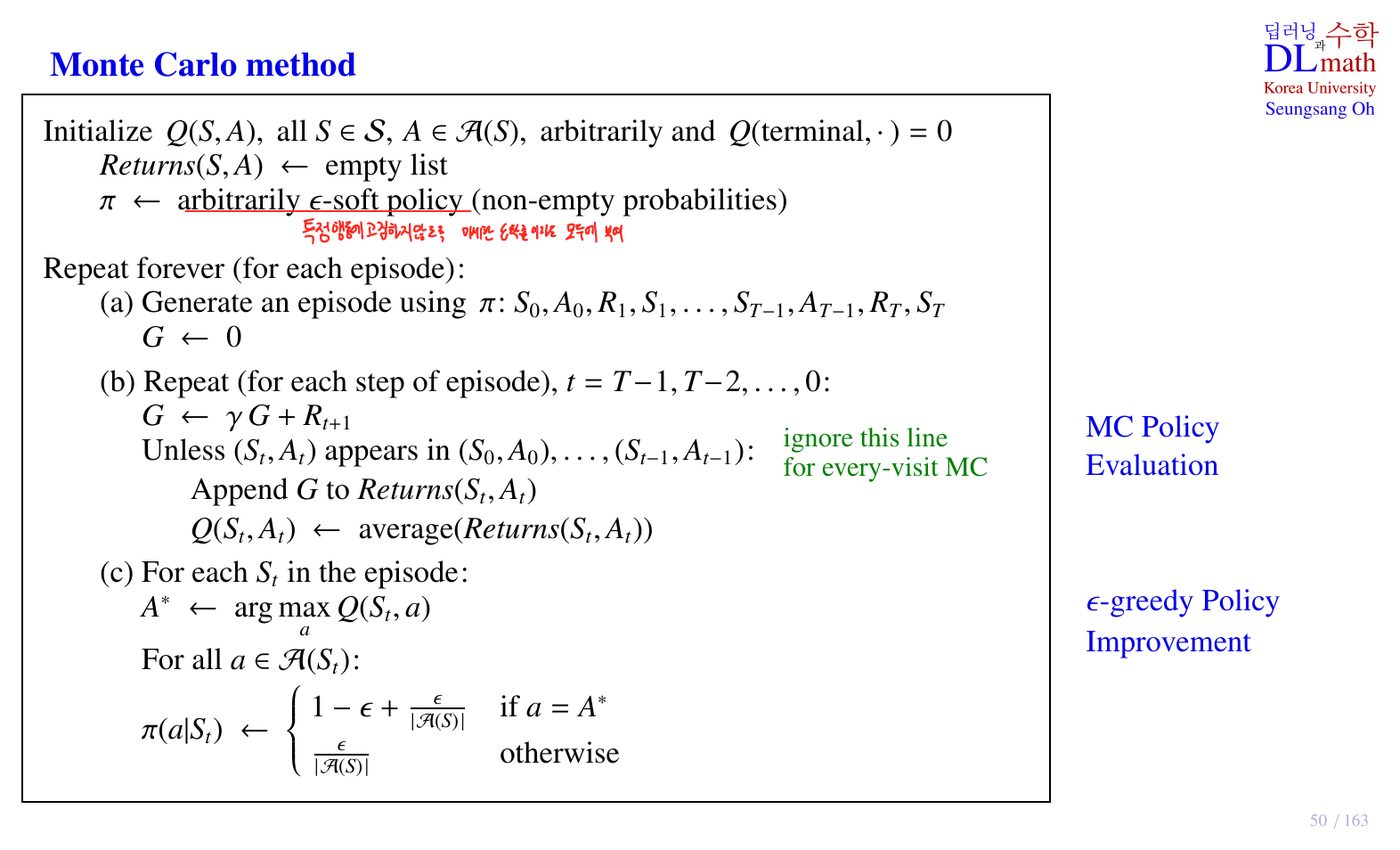
왜 뒤에서부터 계산하나
\(G_t=R_{t+1}+\gamma G_{t+1}\)이라는 재귀 관계 때문입니다. 마지막 시점부터 \(G\leftarrow\gamma G+R_{t+1}\)을 한 번씩 하면 모든 \(G_t\)를 한 번의 훑기로 얻습니다. 앞에서부터 하면 매 시점마다 끝까지 다시 더해야 합니다.
first-visit 조건이 왜 “앞쪽에 나왔는지”를 보나
뒤에서부터 훑기 때문에, 지금 시점 \(t\)보다 앞에 같은 \((S_t,A_t)\)가 있다면 지금은 첫 방문이 아닙니다. 그런 경우를 건너뛰면 첫 방문의 return만 기록됩니다.
(a)는 경험 수집, (b)는 MC Policy Evaluation, (c)는 ε-greedy Policy Improvement입니다. 에피소드 하나마다 PE와 PI를 한 번씩 번갈아 하므로 episode-by-episode GPI입니다.
Temporal Difference: Sarsa, Q-learning p.51
끝날 때까지 기다리지 말고, 한 걸음 갈 때마다 예상을 고쳐라.
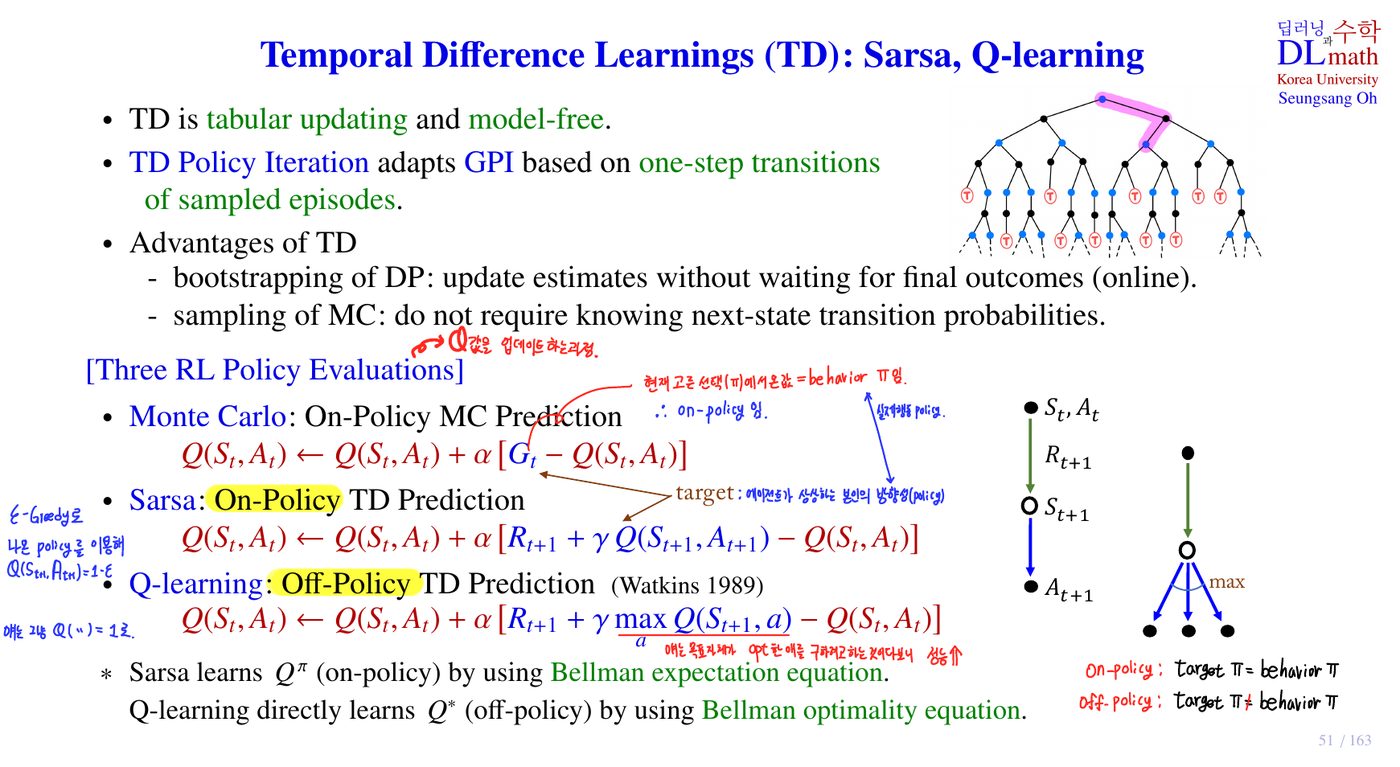
- TD도 tabular updating이고 model-free입니다.
- TD Policy Iteration은 샘플 에피소드의 one-step transitions을 단위로 GPI를 합니다.
- TD의 장점
- DP의 bootstrapping: 최종 결과를 기다리지 않고 추정치를 갱신합니다(online).
- MC의 sampling: 다음 상태의 transition probability를 알 필요가 없습니다.
회사를 나서며 “30분 걸리겠다”고 예상합니다. 엘리베이터를 기다리느라 5분이 지났고, 지하철역에서 다시 보니 “아직 30분 남았다”고 판단됩니다. MC는 집에 도착해서야 “실제로 40분 걸렸다”며 처음 예측을 고칩니다. TD는 역에 도착한 순간 “5분(실제 보상) + 30분(새 예상) = 35분이었네”라며 처음 예측 30분을 바로 고칩니다. 아직 도착하지 않았지만 “새 예상”이라는 추정치를 이용해 고치는 것이 bootstrapping입니다.
세 가지 RL Policy Evaluation
Monte Carlo · On-Policy MC Prediction
\[Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\alpha\big[G_t-Q(S_t,A_t)\big]\]Sarsa · On-Policy TD Prediction
\[Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\alpha\big[R_{t+1}+\gamma Q(S_{t+1},A_{t+1})-Q(S_t,A_t)\big]\]Q-learning · Off-Policy TD Prediction
\[Q(S_t,A_t)\leftarrow Q(S_t,A_t)+\alpha\big[R_{t+1}+\gamma\max_aQ(S_{t+1},a)-Q(S_t,A_t)\big]\]괄호 안 첫 항을 target이라고 합니다. 셋의 차이는 target뿐입니다.
- MC: target = \(G_t\). 실제 return이므로 추정치가 들어가지 않습니다. 정책 \(\pi\)를 따라 얻은 값이므로 on-policy.
- Sarsa: target = \(R_{t+1}+\gamma Q(S_{t+1},A_{t+1})\). 다음 action \(A_{t+1}\)을 실제로 행동할 정책(ε-greedy)으로 고릅니다. 필기 메모처럼, ε-greedy로 고른 \(A_{t+1}\)의 \(Q\)는 확률 \(1-\epsilon\)으로 최댓값이고 나머지는 무작위 값입니다. 행동하는 정책과 배우는 정책이 같으므로 on-policy.
- Q-learning: target = \(R_{t+1}+\gamma\max_aQ(S_{t+1},a)\). 다음 상태에서 실제로 무엇을 할지와 무관하게 가장 좋은 action의 값을 씁니다. 행동은 ε-greedy로 하면서 배우는 것은 greedy(최적) 정책이므로 off-policy. 필기 메모: target을 최적으로 두어 최적 정책을 직접 구하게 하므로 성능이 좋습니다.
Sarsa는 \(Q^\pi\)를 Bellman expectation equation으로 배웁니다(on-policy). \(q_\pi(s,a)=\mathbb E_\pi[R_{t+1}+\gamma q_\pi(S_{t+1},A_{t+1})]\)의 샘플 버전입니다.
Q-learning은 \(Q^*\)를 Bellman optimality equation으로 직접 배웁니다(off-policy). \(q_*(s,a)=\mathbb E[R_{t+1}+\gamma\max_{a'}q_*(S_{t+1},a')]\)의 샘플 버전입니다.
Sarsa와 Q-learning 알고리즘 비교 p.52
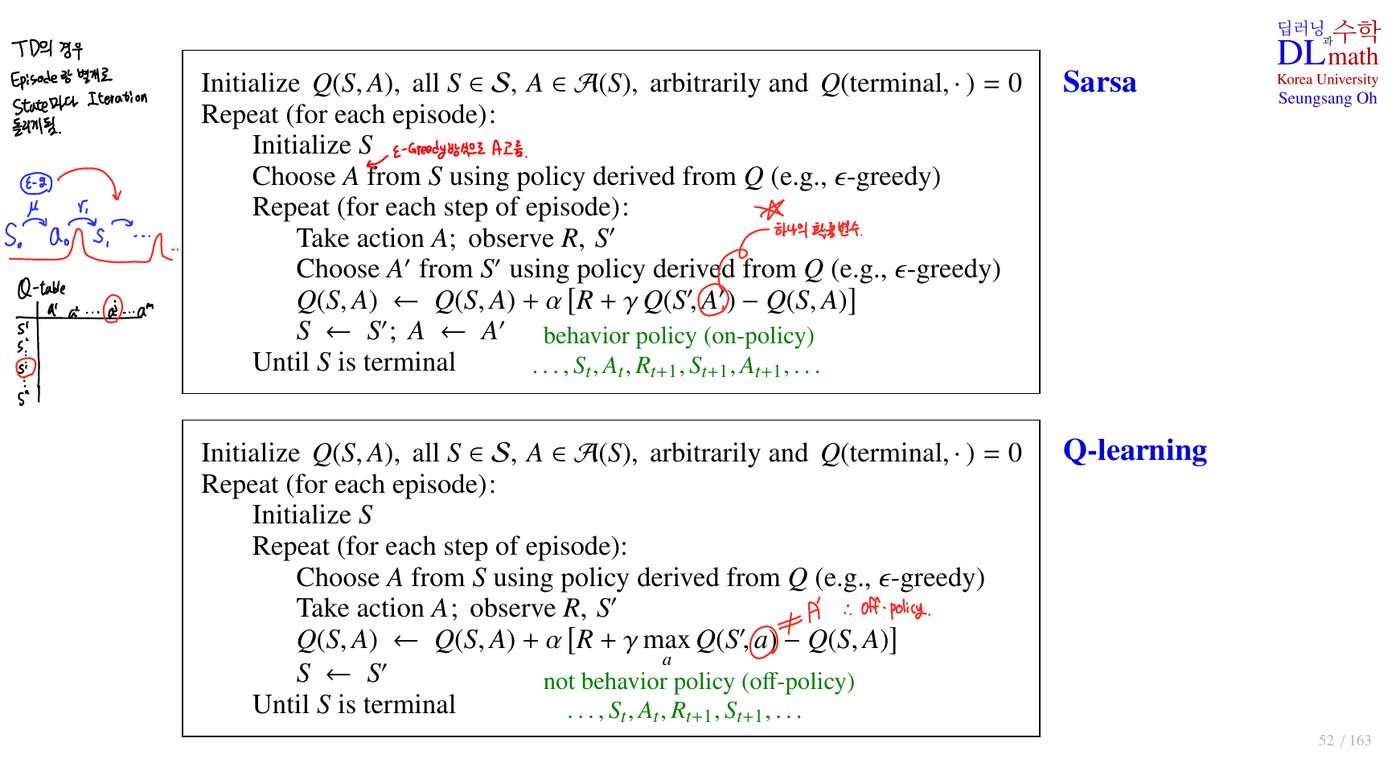
차이를 정확히 짚기
- Sarsa는 업데이트 전에 다음 action \(A'\)을 ε-greedy로 정하고, 그 \(A'\)을 target에 쓰며, 다음 단계에서 실제로 그 \(A'\)을 실행합니다(\(A\leftarrow A'\)). target에 쓴 action = 실제 행동한 action. 그래서 behavior policy(on-policy)이고, 사용하는 다섯 개 \(S,A,R,S',A'\)의 머리글자가 이름이 되었습니다.
- Q-learning은 target에 \(\max_aQ(S',a)\)를 씁니다. 그런데 다음 단계에서 실제로 하는 행동은 루프 처음에 ε-greedy로 새로 고릅니다. 그래서 target에 쓴 action(argmax)과 실제 행동한 action이 다를 수 있습니다(\(\epsilon\) 확률로). 이것이 not behavior policy(off-policy)입니다. 필기: 업데이트에 쓰는 \(a\)는 \(A'\)이 아니라 max를 주는 \(a\).
- Q-learning은 업데이트에 \(S,A,R,S'\) 네 개만 있으면 됩니다(필기).
바로 이 차이 때문에 59쪽 cliff walking에서 Sarsa는 절벽에서 먼 안전한 길(safer path)을, Q-learning은 절벽에 붙은 최적 경로(optimal path)를 배웁니다. Sarsa의 값에는 “ε 확률로 미끄러져 절벽에 떨어지는 위험”이 포함되기 때문입니다. 자세한 그림과 그래프는 59쪽 절에 있습니다.
On-Policy vs Off-Policy p.53
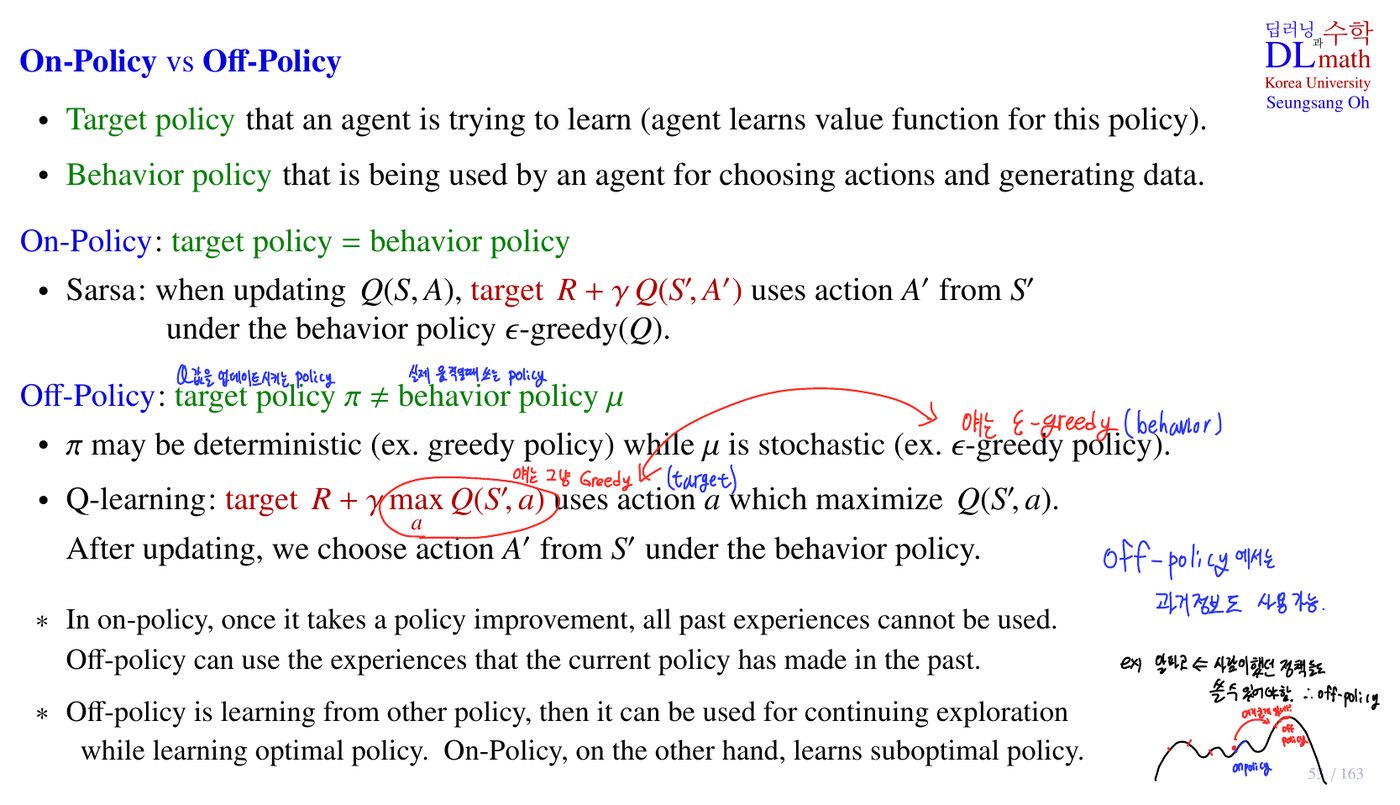
- Target policy: 에이전트가 배우려는 정책 (이 정책의 value function을 학습함). 필기: Q값을 업데이트시키는 policy.
- Behavior policy: 에이전트가 실제로 action을 고르고 데이터를 만드는 정책. 필기: 실제 움직일 때 쓰는 policy.
On-Policy: target = behavior
Sarsa는 \(Q(S,A)\)를 갱신할 때 target \(R+\gamma Q(S',A')\)에서, behavior policy ε-greedy\((Q)\)로 \(S'\)에서 고른 action \(A'\)을 씁니다.
Off-Policy: target \(\pi\) ≠ behavior \(\mu\)
\(\pi\)는 결정적(greedy)일 수 있고 \(\mu\)는 확률적(ε-greedy)입니다. Q-learning의 target \(R+\gamma\max_aQ(S',a)\)는 \(Q(S',a)\)를 최대화하는 action을 쓰고, 갱신 후에는 behavior policy로 \(S'\)에서 \(A'\)을 고릅니다.
On-policy는 내가 직접 운전하면서 내 운전 습관(실수 포함)을 평가하고 고치는 것입니다. Off-policy는 조수석에서 다른 사람(behavior)의 운전을 보며 “나라면 여기서 최선으로 이렇게 했을 것”(target)이라고 배우는 것입니다. 남이 실수해도 나는 최선의 운전법을 배울 수 있습니다.
- On-policy는 정책을 한 번 개선하면 과거 경험을 모두 쓸 수 없습니다. 옛 정책이 만든 데이터는 지금 정책의 데이터가 아니기 때문입니다. Off-policy는 현재 정책이 과거에 만든 경험도 쓸 수 있습니다(→ Deep RL의 experience replay로 이어짐).
- Off-policy는 다른 정책으로부터 배우므로, 탐험을 계속하면서도 최적 정책을 배울 수 있습니다. On-policy는 탐험하는 정책 자체를 배우므로 suboptimal policy를 배웁니다(ε > 0인 한).
Importance Sampling p.54
원하는 분포에서 샘플을 못 뽑으면, 다른 분포에서 뽑고 “가중치”로 보정한다.
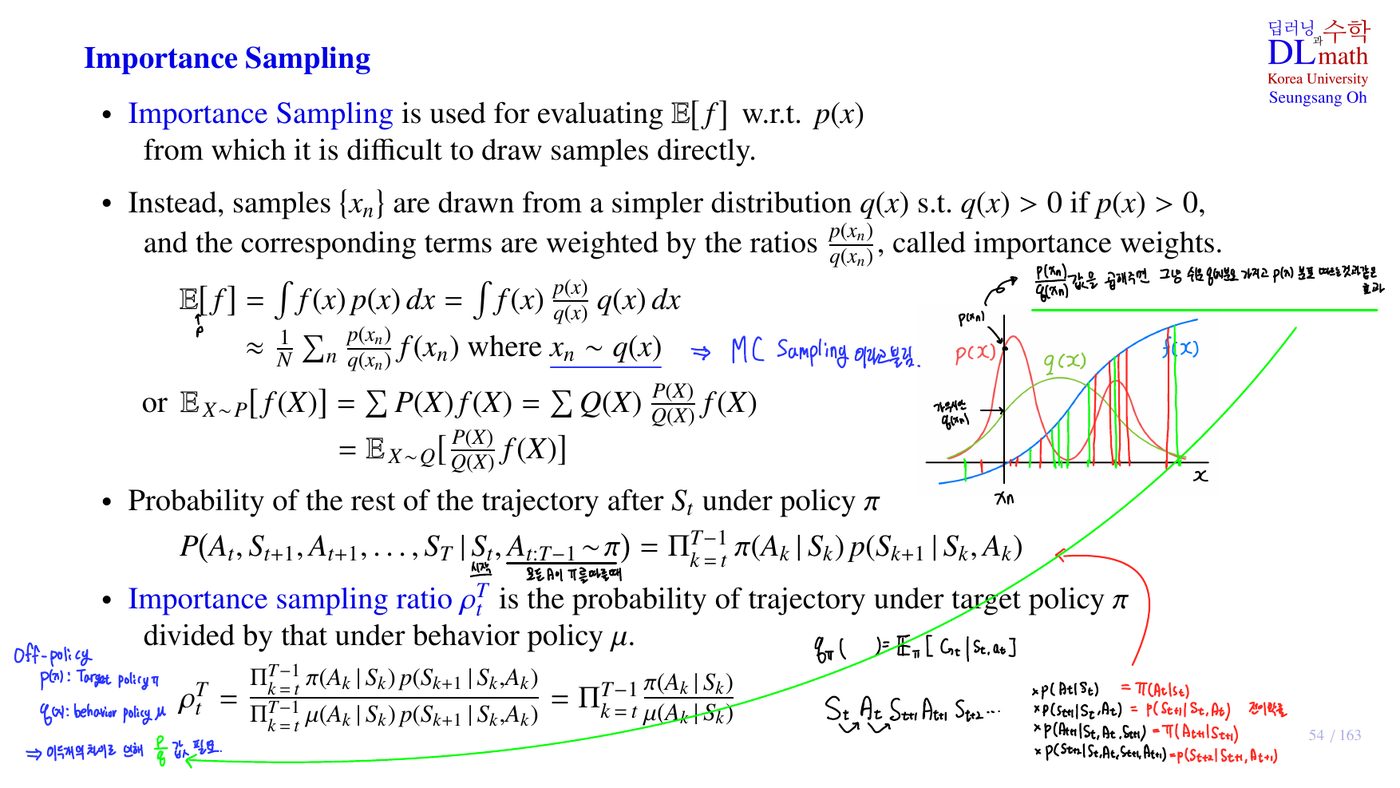
Importance Sampling은 샘플을 직접 뽑기 어려운 분포 \(p(x)\)에 대한 기댓값 \(\mathbb E[f]\)를 구할 때 씁니다. 대신 뽑기 쉬운 분포 \(q(x)\)에서 샘플 \(\{x_n\}\)을 뽑고(단, \(p(x)>0\)인 곳에서는 \(q(x)>0\)이어야 함), 각 샘플에 비율 \(p(x_n)/q(x_n)\)을 곱해 보정합니다. 이 비율을 importance weight라고 합니다.
- 식 자체는 \(\frac{q(x)}{q(x)}=1\)을 곱한 것뿐입니다. 그런데 그렇게 쓰면 “\(q\)로 뽑은 샘플의 평균”으로 바뀌어서 MC sampling을 할 수 있습니다(필기).
- 조건 \(q(x)>0\) if \(p(x)>0\): \(p\)에서 나올 수 있는 값은 \(q\)에서도 나올 수 있어야 합니다. 안 그러면 그 영역은 영영 샘플링되지 않습니다.
- 필기: \(p(x_n)/q(x_n)\)은 곱해 주면 그냥 \(q\)에서 뽑은 \(x_n\)이 \(p\) 분포에서 뽑은 것처럼 보정됩니다.
앞면 확률이 0.9인 동전(\(p\))의 기대 보상(앞면 +1, 뒷면 0 → 정답 0.9)을 알고 싶은데, 공정한 동전(\(q\), 0.5)만 던질 수 있다고 합시다. 앞면이 나오면 가중치 \(0.9/0.5=1.8\), 뒷면이면 \(0.1/0.5=0.2\). 공정한 동전을 100번 던져 앞면 50번이 나왔다면 추정치는 \(\frac1{100}(50\times1.8\times1+50\times0.2\times0)=0.9\). 정답이 나옵니다.
강화학습에 적용: 궤적의 확률 비
\(S_t\) 이후 정책 \(\pi\)를 따를 때 나머지 궤적의 확률은
Importance sampling ratio \(\rho^T_t\)는 target policy \(\pi\) 아래 궤적 확률을 behavior policy \(\mu\) 아래 궤적 확률로 나눈 것입니다.
분자·분모의 \(p(S_{k+1}|S_k,A_k)\)는 같은 환경이니 똑같아서 지워집니다. 남는 것은 두 정책의 비율뿐이고, 정책은 내가 아는 것이므로 모델(p)을 몰라도 계산할 수 있습니다. off-policy RL에서 importance sampling을 쓸 수 있는 이유입니다. 필기: off-policy에서 \(p\)는 target policy \(\pi\), \(q\)는 behavior policy \(\mu\) → 이것으로 \(\mathbb E_\pi[G_t|S_t,A_t]\)를 \(\mu\)의 데이터로 추정.
Off-policy MC와 TD의 importance sampling p.55
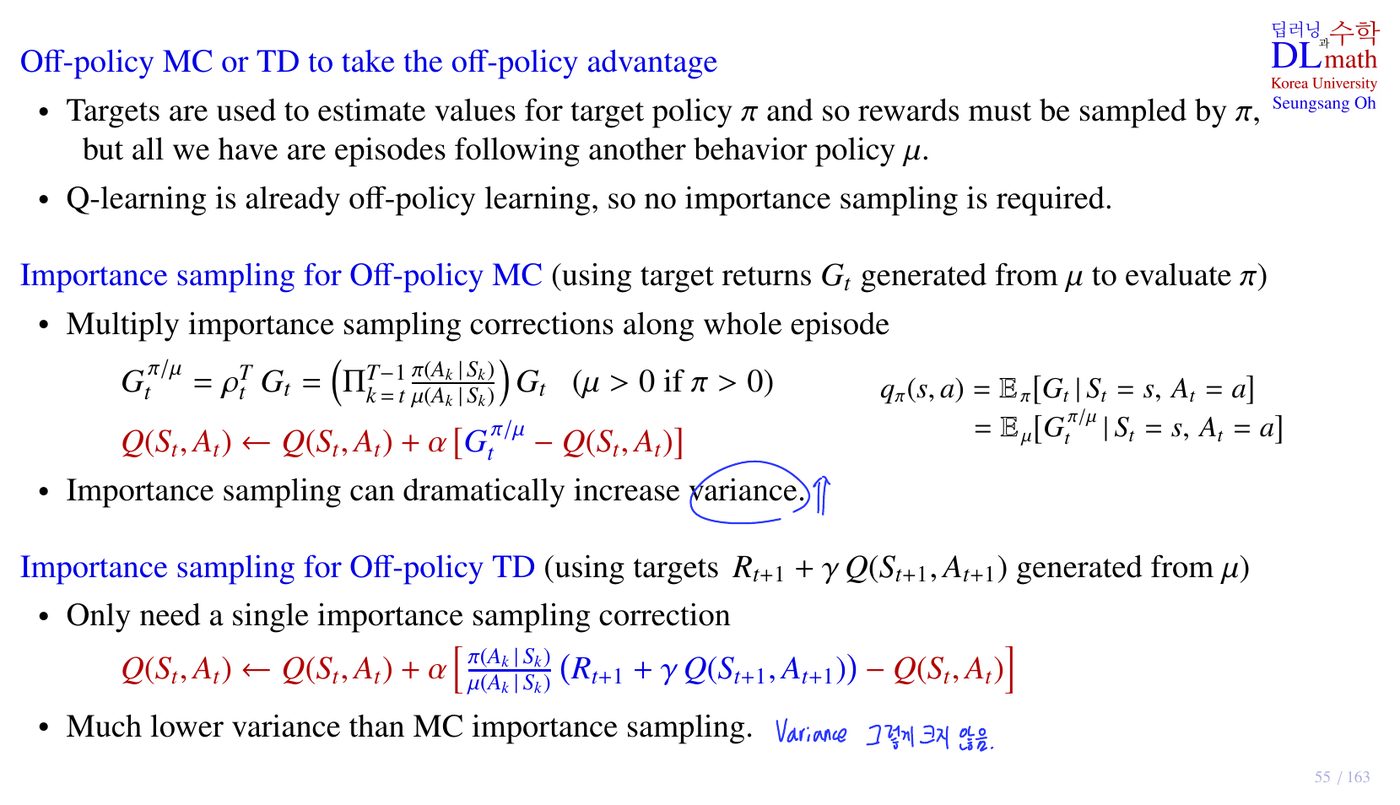
- target은 target policy \(\pi\)의 값을 추정하므로 보상도 \(\pi\)로 샘플링해야 하는데, 가진 것은 다른 behavior policy \(\mu\)를 따른 에피소드뿐입니다.
- Q-learning은 이미 off-policy 학습이라서 importance sampling이 필요 없습니다. 이유: Q-learning target \(R+\gamma\max_aQ(S',a)\)에서 샘플로 들어오는 것은 \(R\)과 \(S'\)뿐이고, 이건 환경이 정합니다(어떤 정책이든 \((S,A)\)가 같으면 분포가 같음). 다음 action은 샘플이 아니라 max로 정하므로 \(\mu\)의 흔적이 target에 없습니다.
Importance sampling for Off-policy MC
\(\mu\)가 만든 return \(G_t\)로 \(\pi\)를 평가합니다. 에피소드 전체에 걸쳐 보정을 곱합니다.
Importance sampling은 분산(variance)을 크게 키울 수 있습니다. 비율을 에피소드 길이만큼 곱하기 때문입니다. 예: target \(\pi\)가 greedy(선택 action 확률 1)이고 \(\mu\)가 그 action을 0.5, 0.25 확률로 골랐다면 두 step만에 \(\rho=\frac1{0.5}\cdot\frac1{0.25}=8\). 반대로 \(\mu\)가 \(\pi\)라면 절대 안 할 action을 한 번이라도 하면 \(\rho=0\). 가중치가 0과 큰 수 사이를 오가니 추정이 크게 출렁입니다.
Importance sampling for Off-policy TD
TD target \(R_{t+1}+\gamma Q(S_{t+1},A_{t+1})\)은 한 step만 쓰므로 보정도 한 번이면 됩니다.
MC importance sampling보다 분산이 훨씬 작습니다. 비율 하나만 곱하므로 필기처럼 “variance가 그렇게 크지 않습니다”. 56쪽 bias/variance 비교와 같은 구조입니다. MC는 여러 step의 무작위성이 누적되고, TD는 한 step만입니다.
MC vs TD의 근본 차이: 편향과 분산 p.56–57
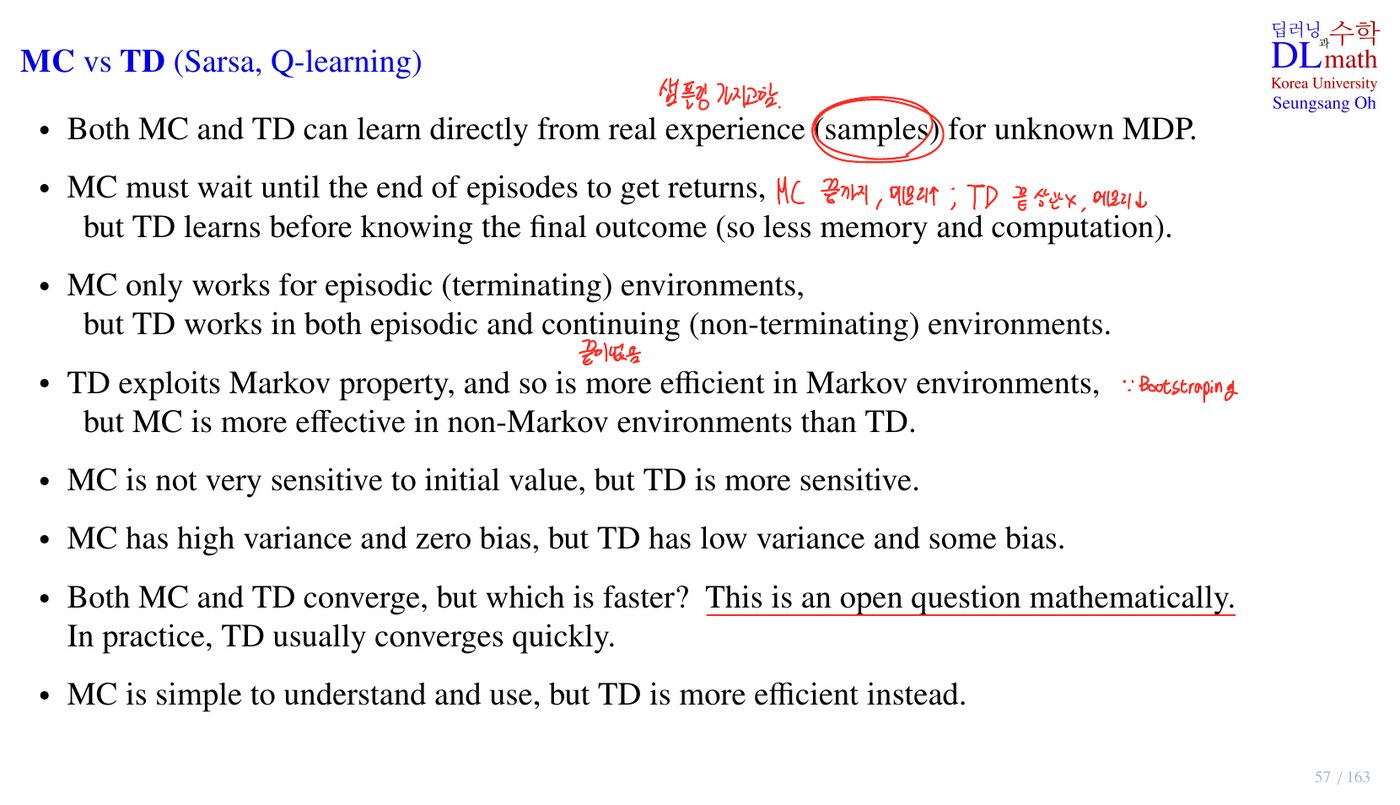
정답 근처지만 들쭉날쭉한 MC, 일관되지만 살짝 비켜난 TD.
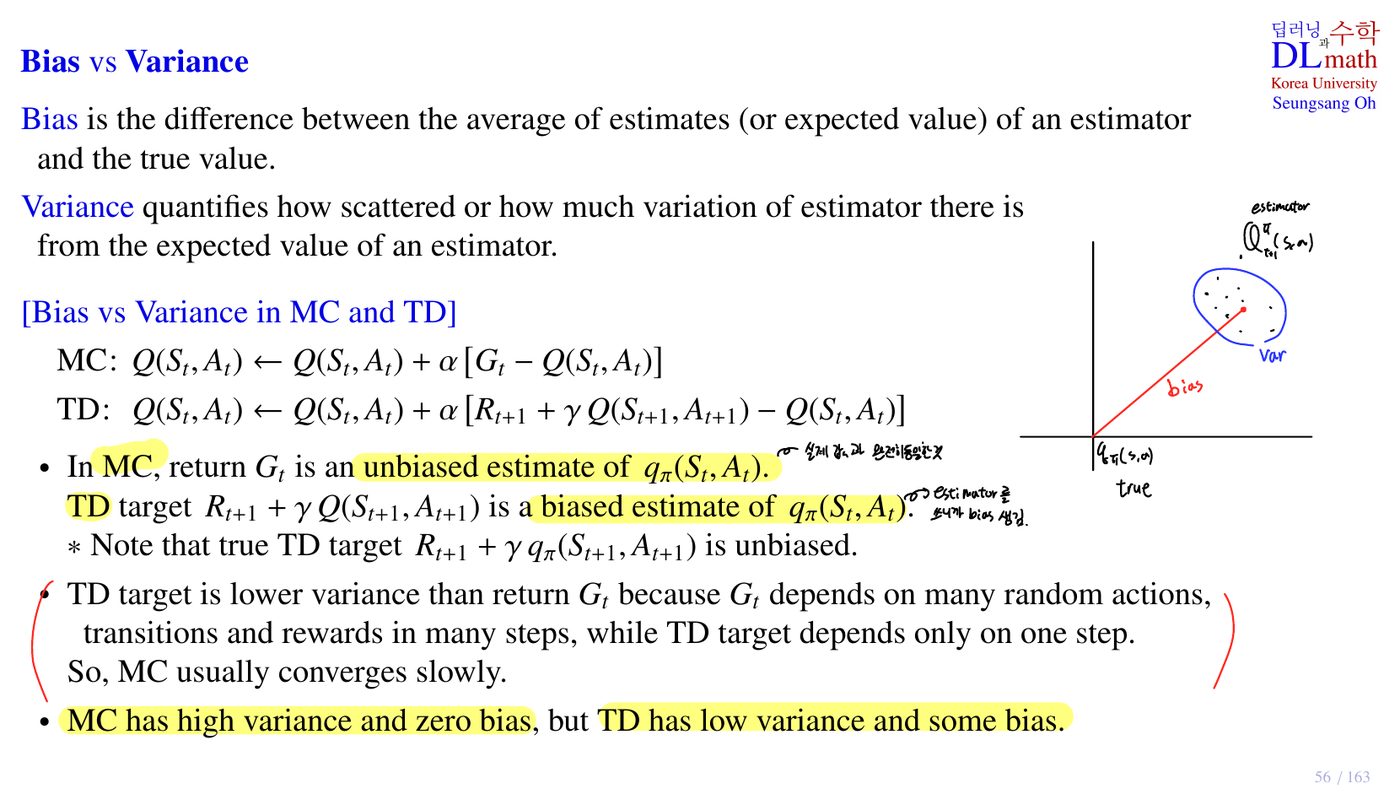
교수님이 MC와 TD를 비교할 때 가장 강조하는 기준은 업데이트 시점이 아니라 통계적 성질입니다. 먼저 두 용어를 정확히 짚습니다.
- Bias(편향): 추정량(estimator)의 평균(기댓값)과 참값의 차이. 여러 번 추정했을 때 평균적으로 과녁 중심을 맞히는가.
- Variance(분산): 추정량이 자기 평균 주위로 얼마나 흩어져 있는가. 한 번 한 번의 추정이 얼마나 들쭉날쭉한가.
두 방법이 \(q_\pi(S_t,A_t)\)를 추정하려고 쓰는 target을 나란히 놓으면 차이가 바로 보입니다.
MC: 분산은 매우 크지만 편향은 없다
- 분산이 큰 이유: \(G_t\)에는 에피소드가 끝날 때까지의 모든 무작위성이 누적됩니다. 매 step마다 정책이 action을 무작위로 고르고(\(\pi\)), 환경이 다음 상태를 무작위로 정하고(\(p\)), 보상도 무작위입니다. 이것이 수십·수백 step 쌓이므로 같은 \((s,a)\)에서 출발해도 \(G_t\)는 판마다 크게 달라집니다.
- 편향이 없는 이유: \(G_t\)는 추정치가 하나도 섞이지 않은, 실제로 받은 보상의 합입니다. 정의상 \(q_\pi(s,a)=\mathbb E_\pi[G_t|S_t=s,A_t=a]\)이므로 \(G_t\)는 \(q_\pi\)의 unbiased estimate입니다. 평균만 충분히 내면 정확히 정답으로 갑니다.
- Markov property가 깨져도 덜 다칩니다: 다음 상태의 값(추정치)에 기대지 않고 전체 에피소드의 실제 결과를 보기 때문입니다.
- 초기값에 둔감합니다: target \(G_t\)에 \(Q\)가 들어가지 않으므로 초기 \(Q\)가 엉터리여도 target은 오염되지 않습니다. 실제로 incremental mean(\(1/n\))이면 첫 방문 때 \(Q\leftarrow Q+\frac11(G_t-Q)=G_t\)가 되어 초기값이 완전히 지워집니다.
TD: 분산은 작지만 약간의 편향이 있다
- 분산이 작은 이유: target에 들어가는 무작위성은 한 step뿐입니다. 보상 하나 \(R_{t+1}\), 전이 하나 \(S_{t+1}\), action 하나 \(A_{t+1}\). 그 뒤의 미래는 이미 저장된 숫자 \(Q(S_{t+1},A_{t+1})\)로 대신하므로 출렁임이 적습니다.
- 편향이 생기는 이유: \(Q(S_{t+1},A_{t+1})\)는 참값 \(q_\pi\)가 아니라 추정치(estimator)입니다. 틀린 값을 target에 넣으면 그 오차가 그대로 들어오므로 TD target은 \(q_\pi\)의 biased estimate입니다. 참고로 진짜 \(q_\pi\)를 넣은 “true TD target” \(R_{t+1}+\gamma q_\pi(S_{t+1},A_{t+1})\)은 unbiased입니다. 편향은 오로지 추정치를 쓰는 데서(bootstrapping) 옵니다.
- Markov property에 예민합니다: “다음 상태의 값이 미래 전체를 요약한다”는 가정(Markov)이 있어야 \(Q(S_{t+1},\cdot)\)로 미래를 대신할 수 있습니다. 가정이 깨지면 그 요약이 틀리고, TD는 틀린 요약을 계속 끌어다 씁니다. 반대로 Markov 환경에서는 이 구조를 활용하므로 MC보다 효율적입니다.
- 초기값에 예민합니다: 학습 초반의 \(Q\)는 초기값 그대로라서 target이 처음부터 그 초기값에 오염됩니다. 이 오차는 bootstrapping을 타고 앞쪽 상태로 전파되고, 씻겨 나가는 데 시간이 걸립니다.
| MC | TD | |
|---|---|---|
| target | \(G_t\) (실제 return) | \(R_{t+1}+\gamma Q(S_{t+1},A_{t+1})\) (추정치 포함) |
| 무작위성 | 에피소드 끝까지 전부 누적 | 한 step만 |
| Variance | high | low |
| Bias | zero (unbiased) | some (biased) |
| Markov 깨질 때 | 덜 다침 (non-Markov에서 더 효과적) | 예민함 (Markov에서 더 효율적) |
| 초기값 | 둔감 | 예민 |
| 수렴 | 대개 느림 (분산 때문) | 대개 빠름 (단, 수학적으로는 open question) |
AB example: MC와 TD의 철학 차이 p.58
같은 데이터를 보고 MC는 0, TD는 0.75라고 답한다. 누가 맞을까?
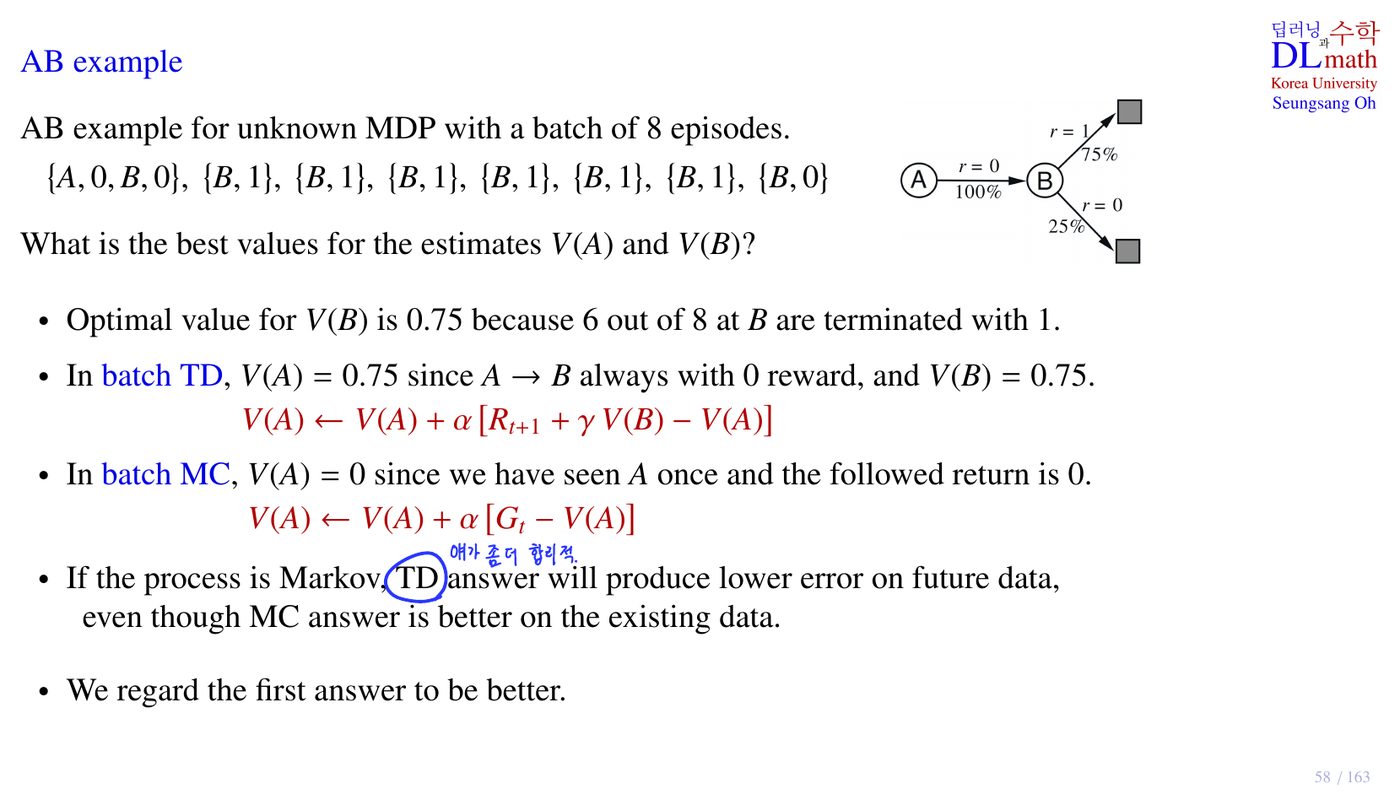
model을 모르는 상태에서 에피소드 8개가 주어졌습니다(\(\gamma=1\)). A에서 시작한 에피소드는 단 하나뿐입니다.
| 에피소드 | 내용 | 횟수 |
|---|---|---|
| A → B | A에서 보상 0 받고 B로, B에서 보상 0 받고 종료 | 1 |
| B | B에서 보상 1 받고 종료 | 6 |
| B | B에서 보상 0 받고 종료 | 1 |
V(B)는 두 방법 모두 같습니다. B는 8번 나왔고 그중 6번이 보상 1로 끝났으므로 \(V(B)=6/8=0.75\).
batch MC: V(A) = 0
\(V(A)\leftarrow V(A)+\alpha[G_t-V(A)]\)
A를 본 건 한 번이고, 그 판의 return은 \(0+0=0\)이었습니다. MC는 철저하게 주어진 데이터(과거)에만 충실해서 “A에서 시작한 판은 전부 0으로 끝났다”고 평가합니다.
batch TD: V(A) = 0.75
\(V(A)\leftarrow V(A)+\alpha[R_{t+1}+\gamma V(B)-V(A)]\)
A는 (데이터상 100%) 보상 0을 받고 B로 갑니다. 그러면 A의 가치는 \(0+V(B)=0.75\)입니다. TD는 A 다음에 이어지는 B의 가치를 target으로 삼습니다.
왜 TD의 답이 더 낫다고 하나
A에서 출발한 그 한 판이 0으로 끝난 건 A 때문이 아니라 B에서 운이 나빴기 때문입니다(B는 25% 확률로 0). MC는 이 한 번의 불운을 A의 가치로 그대로 받아들입니다. TD는 데이터 전체에서 “A → B는 항상 보상 0”, “B는 75%로 1”이라는 구조(Markov 모델)를 사실상 추정하고, 그 구조 위에서 A의 가치를 계산합니다. B에 대한 8번의 경험이 A의 평가에도 쓰이는 것입니다.
신입 A는 입사하면 항상 B팀으로 배치됩니다. B팀 프로젝트는 지금까지 8번 중 6번 성공했습니다. A가 B팀에 가서 맡은 첫 프로젝트는 실패했습니다. MC식 평가는 “A가 관여한 프로젝트 성공률 0%(1건 중 0건)”이고, TD식 평가는 “A는 B팀으로 가고, B팀 성공률은 75%이니 A가 맡을 다음 프로젝트도 75%”입니다. 다음 프로젝트 결과를 더 잘 맞히는 쪽은 TD입니다.
- MC 답은 이미 가진 데이터에서는 오차가 가장 작습니다(관찰된 return 그대로).
- 과정이 Markov라면 TD 답이 앞으로 생길 데이터(future data)에서 오차가 더 작습니다. 그래서 슬라이드는 “We regard the first answer to be better”라며 TD 쪽을 택합니다.
- 이 예는 앞 절의 성질과 그대로 연결됩니다. TD는 Markov property를 활용(bootstrapping)해서 데이터를 더 효율적으로 쓰고, MC는 그것을 쓰지 않아 데이터가 적은 상태(A)에서 분산 큰 추정을 합니다.
Sarsa vs Q-learning: Cliff walking p.59
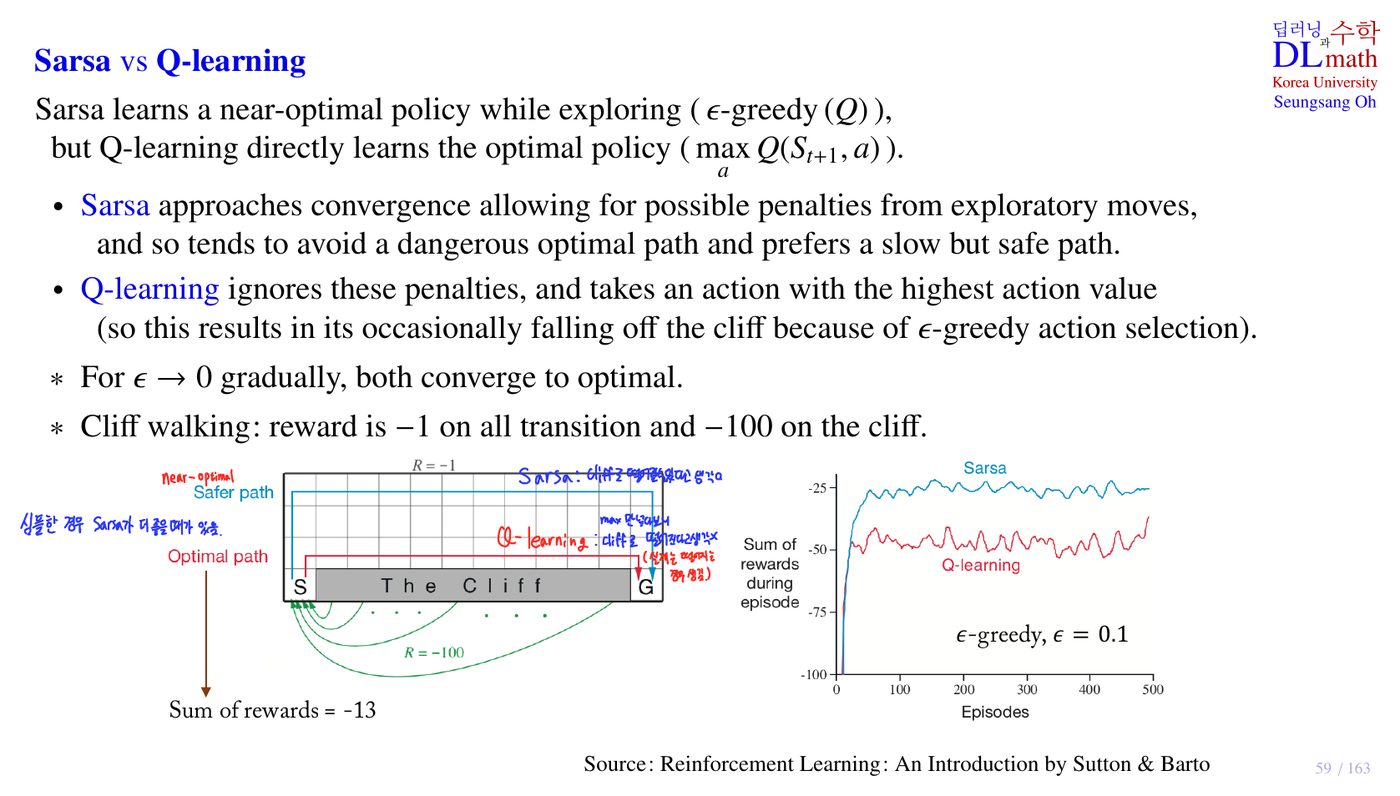
Sarsa는 탐험을 하면서(\(\epsilon\)-greedy\((Q)\)) 그 탐험까지 포함한 거의 최적(near-optimal) 정책을 배우고, Q-learning은 target에 \(\max_aQ(S_{t+1},a)\)를 써서 최적 정책을 직접 배웁니다.
Cliff walking: 모든 이동에 보상 −1, 절벽(The Cliff)에 떨어지면 −100이고 출발점 S로 돌아갑니다. S에서 G까지 가야 합니다. 행동은 \(\epsilon\)-greedy(\(\epsilon=0.1\)).
Sarsa → Safer path
Sarsa는 탐험 중에 받을 수 있는 벌점까지 감안하면서 수렴하므로, 위험한 최적 경로를 피하고 느리지만 안전한 길을 택하는 경향이 있습니다. Sarsa target에는 실제로 고른 \(A'\)이 들어가므로, 절벽 옆 칸의 Q값에 “10% 확률로 엉뚱한 방향을 골라 떨어지는 −100”이 섞입니다. 그래서 절벽 옆 칸이 낮게 평가되고 위쪽으로 돌아갑니다(필기: near-optimal).
Q-learning → Optimal path
Q-learning은 이런 탐험 벌점을 무시하고 action value가 가장 큰 action을 기준으로 배웁니다. target이 max이므로 “다음엔 최선을 다한다”고 가정하고, 절벽 바로 위 최단 경로(sum of rewards = −13)를 배웁니다. 하지만 실제로는 \(\epsilon\)-greedy로 움직이니 가끔 절벽으로 떨어집니다(필기: 실제는 떨어져서 위험 생김).
- 오른쪽 그래프(episode 중 받은 보상 합): Sarsa(위, 약 −25)가 Q-learning(아래, 약 −50)보다 높습니다. 학습 중 성적은 Sarsa가 좋고, 배운 정책(greedy로 실행)은 Q-learning이 최적입니다. 필기: 실용적인 경우(탐험을 멈출 수 없는 실제 로봇 등) Sarsa가 더 좋을 때가 있음.
- For \(\epsilon\to0\) gradually, both converge to optimal. 탐험이 사라지면 Sarsa의 target도 max와 같아지기 때문입니다.
Expected Sarsa p.60
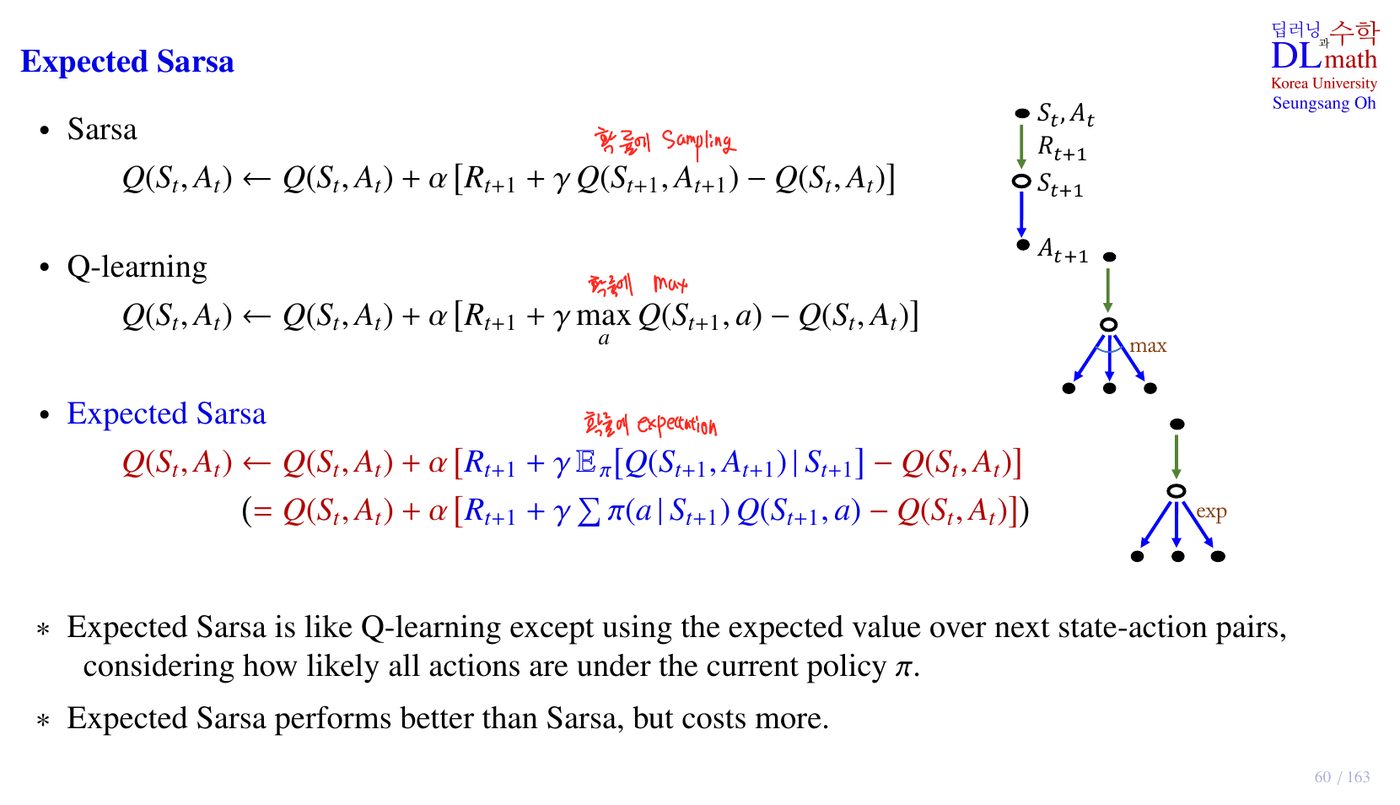
- Expected Sarsa는 Q-learning과 비슷하지만, max 대신 현재 정책 \(\pi\)에서 각 action이 나올 확률을 고려한 기댓값을 다음 상태-행동 값으로 씁니다. backup 그림에서 Q-learning은 다음 상태 아래 가지 중 max, Expected Sarsa는 가지 전체의 확률 가중평균(exp)입니다.
- 왜 Sarsa보다 나은가: Sarsa target에는 \(A_{t+1}\)을 무작위로 하나 뽑는 무작위성이 들어 있습니다. Expected Sarsa는 그 부분을 기댓값으로 바꿔서 없애 버리므로 target의 variance가 작아집니다. 기댓값은 같으니 학습이 더 안정적입니다.
- 대가: 매 업데이트마다 다음 상태의 모든 action에 대해 \(\pi(a|S_{t+1})Q(S_{t+1},a)\)를 더해야 하므로 계산이 더 듭니다. 정리하면 Sarsa보다 성능은 좋지만 비용이 더 듭니다(슬라이드: “Expected Sarsa performs better than Sarsa, but costs more.”).
- 재미있는 관계: \(\pi\)가 greedy이면 \(\sum_a\pi(a|S')Q(S',a)=\max_aQ(S',a)\)이므로 Expected Sarsa = Q-learning입니다. 24쪽에서 본 “\(\sum_a\pi\)가 max로 바뀐다”와 같은 이야기입니다.
Double Q-learning p.61
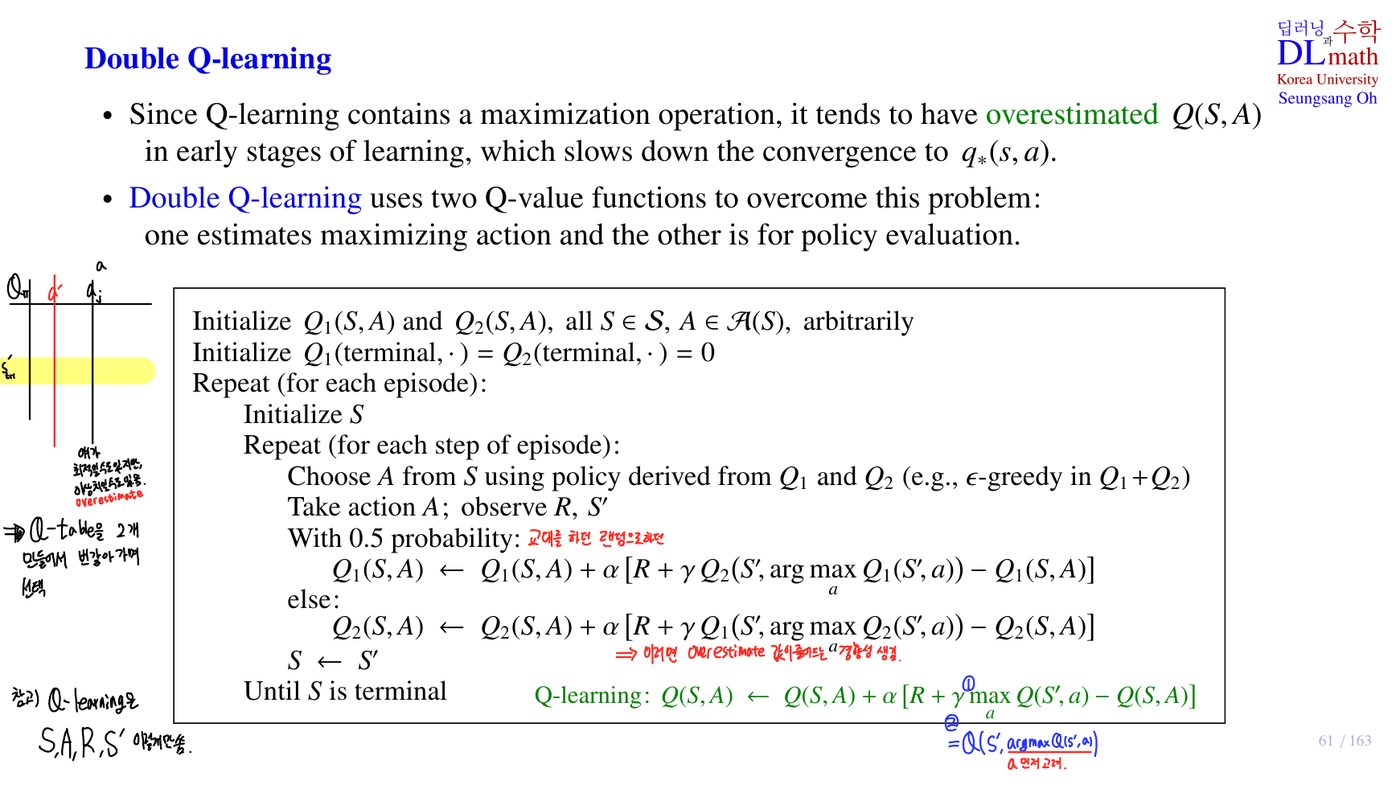
Q-learning에는 max 연산이 들어 있어서, 학습 초기에 \(Q(S,A)\)를 과대평가(overestimated)하는 경향이 있고, 이 때문에 \(q_*(s,a)\)로의 수렴이 느려집니다.
왜 max가 과대평가를 만드나
학습 초기의 Q값은 잡음이 섞인 추정치입니다. 잡음 섞인 값들 중 최댓값을 고르면, 위로 튄 잡음을 골라 들고 오기 쉽습니다. 그래서 \(\mathbb E[\max_a\hat Q(s,a)]\ge\max_a\mathbb E[\hat Q(s,a)]\)가 됩니다.
어떤 상태에서 action 4개의 진짜 값이 모두 0이라고 합시다. 추정치는 각각 잡음 ±1이 섞여서 예를 들어 (−0.6, +0.8, −0.2, +0.3)입니다. 진짜 최댓값은 0인데 max는 +0.8을 고릅니다. 이 과대평가가 target을 타고 앞 상태들로 퍼집니다(필기: 얘가 최댓값으로 잡혀 버리면 오버피팅된 것처럼 overestimate). 비유하면 시험 점수에 운이 섞일 때 “최고 점수 학생”의 다음 시험 점수는 대개 그보다 낮습니다. 최고 점수에 운이 많이 섞여 있었기 때문입니다.
해결: action을 고르는 Q와 평가하는 Q를 분리
Double Q-learning은 Q-value function을 두 개 씁니다. 하나는 최댓값을 주는 action을 고르는 데, 다른 하나는 그 action의 값을 평가하는 데 씁니다.
- \(Q_1\)로 “가장 좋아 보이는 action”을 고르고(argmax), 그 action의 값은 독립적으로 학습된 \(Q_2\)로 읽습니다. \(Q_1\)에서 운 좋게 튄 action이라도 \(Q_2\)에서는 같이 튀어 있을 가능성이 낮으니 과대평가가 줄어듭니다.
- 필기: 0.5 확률로 교대로 업데이트(교대로 하면 균형적으로). 행동 선택은 \(Q_1+Q_2\)에 대한 \(\epsilon\)-greedy.
- 원래 Q-learning과 비교: \(\max_aQ(S',a)=Q(S',\arg\max_aQ(S',a))\)로 쓰면, 같은 Q로 고르고(argmax) 같은 Q로 평가한 것입니다(필기 ① ②). Double Q-learning은 ②의 평가만 다른 Q로 바꾼 것입니다.
- Q-learning은 업데이트에 \(S,A,R,S'\)만 씁니다(필기). 이 아이디어가 Deep RL의 Double DQN으로 이어집니다.
TD(λ): MC와 TD 사이 p.62
한 걸음만 보는 TD와 끝까지 보는 MC 사이에 n-step이 있고, 그 모두를 섞은 것이 TD(λ)입니다.
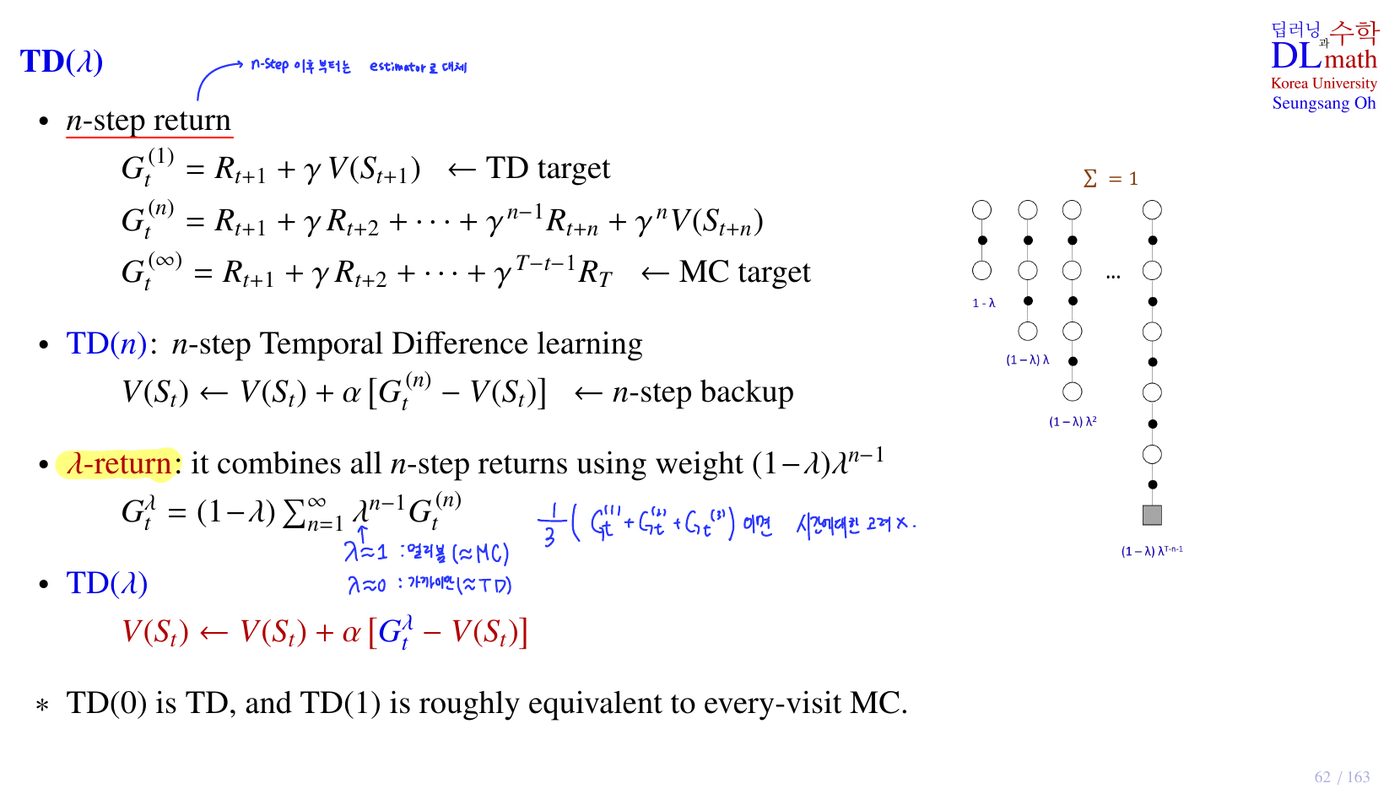
n-step return
실제 보상을 \(n\)개 쓰고, 그 뒤는 추정치 \(V(S_{t+n})\)로 대신합니다(필기: n-step 이후부터는 estimator로 대체). \(n=1\)이면 TD, \(n=\infty\)이면 MC입니다. TD(\(n\)): \(V(S_t)\leftarrow V(S_t)+\alpha[G^{(n)}_t-V(S_t)]\) (n-step backup). \(n\)이 커질수록 실제 보상이 많이 들어가서 bias↓ variance↑, 작을수록 bias↑ variance↓입니다(56쪽의 연장선).
λ-return
그러면 \(n\)을 몇으로 해야 할까요? 하나만 고르지 말고 전부 섞자는 것이 λ-return입니다. it combines all n-step returns using weight \((1-\lambda)\lambda^{n-1}\).
- 가중치 합: \((1-\lambda)(1+\lambda+\lambda^2+\cdots)=(1-\lambda)\cdot\frac1{1-\lambda}=1\) (슬라이드 오른쪽 그림의 Σ = 1). 에피소드가 끝나면 남은 가중치 \(\lambda^{T-t-1}\)이 전부 MC return에 몰립니다.
- 필기: \(\frac13(G^{(1)}_t+G^{(2)}_t+G^{(3)}_t)\)처럼 단순 평균이면 시간에 대한 고려가 없습니다. λ-return은 가까운 n-step에 더 큰 가중치를 기하급수적으로 줍니다.
- \(\lambda\approx1\): 멀리까지 고르게 → MC에 가까움. \(\lambda\approx0\): 거의 \(G^{(1)}\)만 → TD에 가까움. 그래서 TD(0) is TD, and TD(1) is roughly equivalent to every-visit MC.
하나의 표로 묶기
20–62쪽의 모든 방법은 “어떤 Bellman 식을, 어떻게 푸느냐”의 조합입니다.
| 방법 | Bellman 식 | 기댓값 처리 | 평가 대상 | 정책 개선 |
|---|---|---|---|---|
| Value Iteration | optimality | full backup (p 사용) | V | 마지막에 one-step lookahead |
| Policy Evaluation | expectation | full backup (p 사용) | V | — |
| Policy Iteration | expectation → greedy | full backup | V | greedy (deterministic) |
| MC control | expectation (G의 평균) | sample, 에피소드 전체 | Q | ε-greedy, GLIE면 ε=1/k |
| Sarsa | expectation | sample, 한 걸음 + bootstrapping | Q | ε-greedy (on-policy) |
| Q-learning | optimality | sample, 한 걸음 + bootstrapping | Q | target greedy, 행동 ε-greedy (off-policy) |
| Expected Sarsa | expectation (다음 action은 기댓값) | sample \(S'\) + \(\sum_a\pi Q\) | Q | ε-greedy (π가 greedy면 = Q-learning) |
| Double Q | optimality | sample, 고르는 Q ≠ 평가하는 Q | Q₁, Q₂ | \(Q_1+Q_2\)에 ε-greedy (off-policy) |
| Off-policy MC / TD | expectation (π를 μ 데이터로) | importance sampling ratio로 보정 | Q | MC는 ρ를 에피소드 전체 곱, TD는 한 번 |
| TD(λ) | expectation | n-step return들을 \((1-\lambda)\lambda^{n-1}\)로 섞음 | V | λ=0 → TD, λ=1 → MC |
Bellman 식을 안다 → 모델을 알면 계산(DP: VI는 optimality, PI는 expectation+greedy) → 모델을 모르면 샘플로 근사(RL) → 그러려면 \(V\) 대신 \(Q\)가 필요하고, 탐험이 필요해서 ε-greedy와 GLIE가 등장 → 샘플을 에피소드 단위로 쓰면 MC, 한 걸음 단위로 쓰면 TD → TD에서 target을 behavior로 고르면 Sarsa(on), max로 고르면 Q-learning(off), 기댓값으로 고르면 Expected Sarsa → MC와 TD 사이를 n-step과 λ로 잇는 것이 TD(λ).